REST API: co to jest i jak działa na prawdziwym przykładzie
REST API wyjaśnione od źródła: sześć zasad Fieldinga, metody HTTP, kody odpowiedzi i limity — na działającym API, z prawdziwymi odpowiedziami serwera.
REST API to sposób, w jaki jeden program rozmawia z drugim przez HTTP — ten sam protokół, którym przeglądarka pobiera strony. Adres wskazuje zasób, na przykład konkretny link w skracaczu, metoda HTTP mówi, co z nim zrobić (GET — odczytaj, POST — utwórz, DELETE — usuń), a serwer odpowiada kodem statusu i danymi, zwykle w formacie JSON. Sam REST nie jest ani protokołem, ani biblioteką. To styl architektury, który Roy Fielding opisał w 2000 roku w rozprawie doktorskiej. Poniżej najpierw REST od źródła: sześć zasad Fieldinga i to, dlaczego ich autor twierdzi, że większość „REST API” nim nie jest. Potem praktyka na działającym API skracacza DVN Links — prawdziwe żądania i odpowiedzi, które żądanie wolno ponowić, co znaczą kody 401, 403 i 429 i jak zachowuje się limit zapytań, zmierzony zapytanie po zapytaniu.
API — co to jest i czym jest REST API
API (application programming interface) to umowa między programami: jakie pytania jeden może zadać drugiemu, w jakiej postaci je wysłać i jaką odpowiedź dostanie. Interfejs użytkownika jest dla człowieka — przyciski, formularze. API jest dla programu. Gdy sklep internetowy sam pobiera status przesyłki od kuriera albo system mailingowy tworzy krótki link do każdego newslettera, robi to przez API dostawcy, bez klikania w jego panelu.
API w sieci działa zwykle przez HTTP i tu pojawia się nazwa REST. Słownik MDN, prowadzony przez Mozillę, opisuje sytuację uczciwie: potocznie „RESTful API” nazywa się dowolne API po HTTP, choć „they don't necessarily adhere to all REST constraints”, a początkujący mogą przyjąć, że REST API to usługa HTTP, którą da się wywołać standardowymi narzędziami i bibliotekami sieciowymi (MDN, REST). To dobra definicja robocza. „RESTful API” znaczy w praktyce to samo — API zaprojektowane według zasad REST, przynajmniej w takim stopniu, w jakim stosuje je reszta branży.
W ankiecie Postmana z 2025 roku, na którą odpowiedziało ponad 5700 programistów, architektów i osób z kadry kierowniczej, z REST korzysta 93% ankietowanych (Postman, 2025 State of the API Report). To deklaracje użycia, nie udział w ruchu — jeden zespół może używać kilku stylów naraz.
REST API — sześć zasad Fieldinga
REST to zbiór ograniczeń, które Fielding nakłada na architekturę systemu sieciowego. Jego kluczowe pojęcie to zasób: „The key abstraction of information in REST is a resource” — zasobem może być wszystko, co da się nazwać, od dokumentu po obraz (R. Fielding, rozprawa, rozdz. 5). W API skracacza zasobem jest link, a jego nazwą — adres /api/v1/links/{id}. Ograniczeń jest sześć, a każde da się sprawdzić na prawdziwym API:
- Klient–serwer. Interfejs oddziela klienta od przechowywania danych, dzięki czemu obie strony mogą się rozwijać niezależnie. Fielding podkreśla, że to umożliwia ewolucję komponentów „independently”. U nas integracja nie wie, jak wygląda panel ani baza danych — widzi tylko adresy i JSON.
- Bezstanowość. Każde żądanie musi zawierać wszystko, czego serwer potrzebuje, żeby je zrozumieć, i „cannot take advantage of any stored context on the server” — stan sesji trzyma klient. Dlatego nasze API nie ma logowania ani sesji: klucz idzie w każdym żądaniu.
- Cache. Dane w odpowiedzi mają być oznaczone jako nadające się do ponownego użycia albo nie. U nas specyfikacja OpenAPI wraca z nagłówkiem
Cache-Control: public, max-age=3600, ale odpowiedzi z danymi linków nie mają żadnego oznaczenia — to zasada spełniona częściowo. - Jednolity interfejs. Według Fieldinga to cecha, która najbardziej odróżnia REST od innych stylów. Składają się na nią cztery ograniczenia: identyfikacja zasobów, operowanie na nich przez reprezentacje, samoopisujące się komunikaty i „hypermedia as the engine of application state”, w skrócie HATEOAS.
- System warstwowy. Komponent nie widzi niczego poza warstwą, z którą rozmawia bezpośrednio. Odpowiedzi z dvnlinks.pl mają nagłówek
server: cloudflare— między klientem a naszym serwerem stoi CDN, a klient nie musi o tym wiedzieć. - Kod na żądanie. Serwer może rozszerzyć klienta, wysyłając kod do wykonania. Fielding nazywa to „an optional constraint” — jedyna zasada opcjonalna. Nie używamy jej.
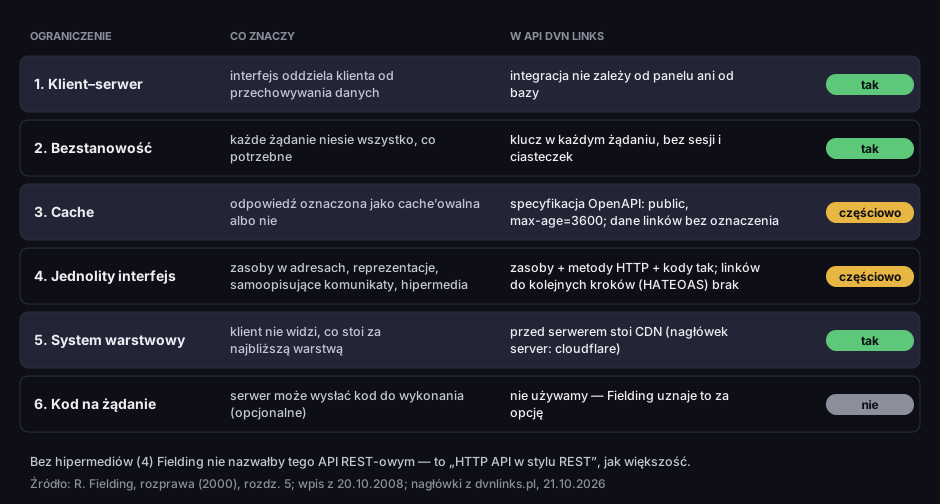
Sześć ograniczeń REST według Fieldinga — i jak wypada nasze API
co znaczy każde ograniczenie i czy API DVN Links je spełnia
Źródło: R. Fielding, rozprawa (2000), rozdz. 5; wpis z 20.10.2008; nagłówki z dvnlinks.pl, 21.10.2026
Opis figury
Tabela sześciu ograniczeń. Klient–serwer: interfejs oddziela klienta od danych; u nas tak. Bezstanowość: każde żądanie niesie wszystko; u nas tak, klucz w każdym żądaniu. Cache: odpowiedź oznaczona jako cache’owalna albo nie; u nas częściowo, specyfikacja OpenAPI z public, max-age=3600, dane linków bez oznaczenia. Jednolity interfejs: zasoby, reprezentacje, samoopisujące komunikaty, hipermedia; u nas częściowo, bez HATEOAS. System warstwowy: u nas tak, przed serwerem CDN, nagłówek server: cloudflare. Kod na żądanie: opcjonalny, u nas nie.
Czwarta zasada to miejsce, w którym prawie każde „REST API” odpada. HATEOAS znaczy, że odpowiedź serwera zawiera linki do kolejnych możliwych kroków, a klient porusza się po nich jak człowiek po stronie WWW, zamiast znać adresy z dokumentacji. Fielding napisał o tym w 2008 roku osobny wpis. Zaczyna się od zdania „I am getting frustrated by the number of people calling any HTTP-based interface a REST API”, a kończy wnioskiem, że jeśli stanem aplikacji nie sterują hipermedia, „then it cannot be RESTful and cannot be a REST API” (R. Fielding, 20.10.2008).
Nasze API tego warunku nie spełnia: odpowiedź z linkiem nie mówi, gdzie go edytować ani usunąć — te adresy zna program, który przeczytał dokumentację. W ścisłym sensie Fieldinga to więc „HTTP API w stylu REST”, jak większość interfejsów, które tak się nazywają. Integracji to nie przeszkadza, ale wyjaśnia, skąd bierze się spór „czy to na pewno REST”.
Anatomia żądania i odpowiedzi
Każde wywołanie REST API to para komunikatów HTTP: żądanie i odpowiedź. Żądanie ma cztery części:
- metodę — co zrobić (
GET,POST,PATCH,DELETE); - adres zasobu — na czym (
/api/v1/linksto kolekcja linków,/api/v1/links/{id}to jeden link); budowę samego adresu, łącznie z parametrami po znaku zapytania, opisuje tekst o adresie URL; - nagłówki — dane o żądaniu: kto pyta (
Authorization) i w jakim formacie jest ciało (Content-Type: application/json); - ciało — dane do zapisania, przy odczycie zwykle puste.
Odpowiedź ma kod statusu (trzy cyfry), nagłówki i ciało. Tak wygląda utworzenie krótkiego linku w naszym API — żądanie i odpowiedź zapisane na lokalnej instancji tego samego kodu, który działa na produkcji:
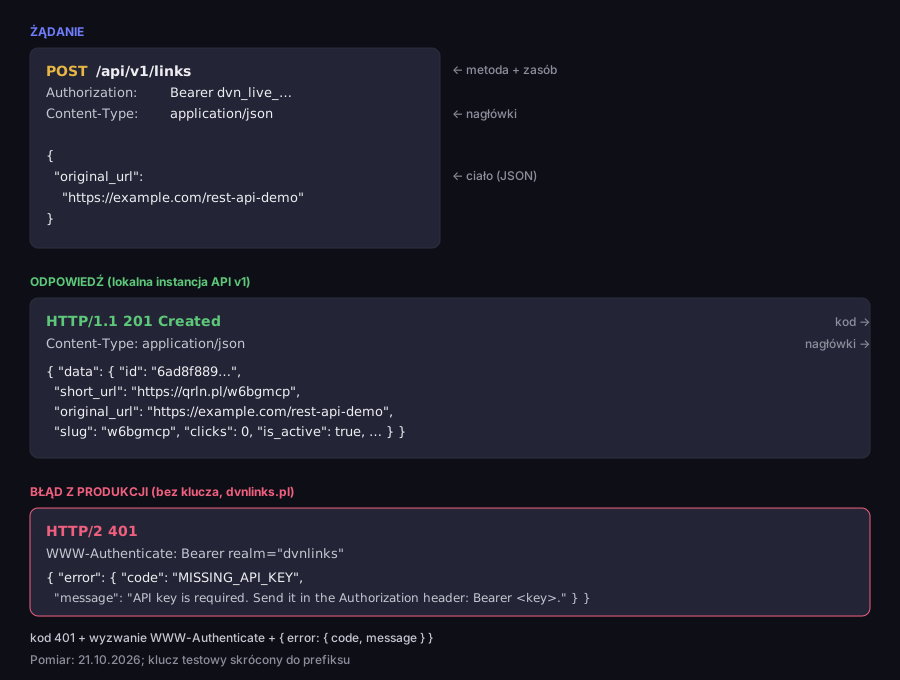
Anatomia wywołania REST API — żądanie, odpowiedź, błąd
POST /api/v1/links na lokalnej instancji; błąd 401 z produkcji, bez klucza
Pomiar: lokalna instancja API v1 i dvnlinks.pl, 21.10.2026; klucz testowy skrócony do prefiksu
Opis figury
Żądanie POST /api/v1/links z nagłówkami Authorization: Bearer dvn*live*… i Content-Type: application/json oraz ciałem {"original_url": "https://example.com/rest-api-demo"}. Odpowiedź HTTP 201 Created, Content-Type: application/json, ciało data z polami id, short_url na domenie qrln.pl, original_url, slug, clicks 0 i is_active true. Poniżej odpowiedź produkcji dvnlinks.pl bez klucza: HTTP 401, nagłówek WWW-Authenticate: Bearer realm="dvnlinks", ciało error z kodem MISSING_API_KEY i komunikatem o nagłówku Authorization.
Dwie rzeczy z tej figury przydają się przy każdym API. Po pierwsze, odpowiedzi mają stały kształt: dane zawsze w obiekcie data, błąd zawsze w error z polami code i message. Program sprawdza kod statusu, a potem error.code — stały identyfikator, w przeciwieństwie do komunikatu dla człowieka. Przy błędzie walidacji dochodzi pole details.field. Wysłanie {"original_url": "nie-adres"} daje 400 VALIDATION_ERROR z "field": "original_url".
Po drugie, błąd 401 nie jest tylko liczbą. Specyfikacja HTTP mówi, że serwer odpowiadający 401 „MUST send a WWW-Authenticate header field” z co najmniej jednym wyzwaniem, czyli informacją, jak się uwierzytelnić (RFC 9110, §15.5.2). Nasze API odsyła WWW-Authenticate: Bearer realm="dvnlinks", a gdy klucz zostanie odrzucony — ma zły format, jest nieznany, wyłączony albo wygasły — dopisuje error="invalid_token". Sprawdziliśmy to na produkcji 21 października 2026 roku zapytaniami bez klucza i z kluczem w złym formacie.
Metody HTTP: które żądanie wolno powtórzyć
Metody HTTP różnią się nie tylko tym, co robią, ale też tym, czy żądanie wolno wysłać drugi raz. To ma znaczenie, gdy połączenie zerwie się, zanim klient przeczyta odpowiedź: nie wiadomo wtedy, czy serwer zdążył coś zrobić.
Specyfikacja HTTP zna dwie właściwości. Metoda bezpieczna to taka, której znaczenie jest „essentially read-only” — klient nie oczekuje żadnej zmiany na serwerze; tak jest z GET (RFC 9110, §9.2.1). Metoda idempotentna to taka, przy której efekt kilku identycznych żądań jest taki sam jak jednego. RFC wymienia PUT, DELETE i metody bezpieczne i wyjaśnia, po co to rozróżnienie: takie żądanie „can be repeated automatically if a communication failure occurs before the client is able to read the server's response” (RFC 9110, §9.2.2).
W poradnikach bywa, że „PUT i PATCH są idempotentne”. O PATCH specyfikacja tej metody mówi coś innego: „PATCH is neither safe nor idempotent”, choć żądanie PATCH da się sformułować tak, żeby idempotentne było (RFC 5789, §2). Wysłaliśmy każde żądanie dwa razy pod rząd do lokalnej instancji naszego API:
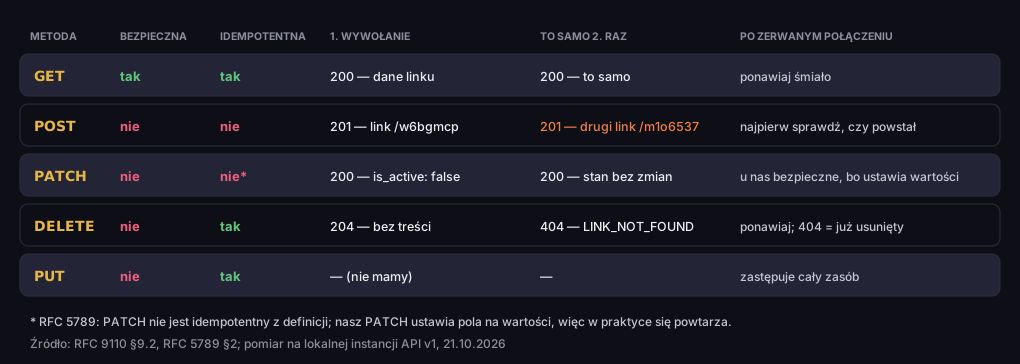
Które żądanie wolno ponowić — metody HTTP i nasz pomiar
pierwsze i drugie identyczne wywołanie na lokalnej instancji API v1
Źródło: RFC 9110 §9.2, RFC 5789 §2; pomiar na lokalnej instancji API v1, 21.10.2026
Opis figury
Tabela. GET: bezpieczna tak, idempotentna tak; 200 z danymi linku, drugi raz 200 to samo; ponawiaj śmiało. POST: nie, nie; 201 i nowy link, drugi raz 201 i drugi, inny link; najpierw sprawdź, czy powstał. PATCH: nie, nie z definicji; 200 is_active false, drugi raz 200 bez zmiany stanu; u nas bezpieczne, bo ustawia wartości. DELETE: nie, tak; 204 bez treści, drugi raz 404 LINK_NOT_FOUND; ponawiaj, 404 znaczy już usunięty. PUT: nie, tak; nie mamy.
Najciekawszy jest DELETE. Drugie wywołanie zwraca inny kod (404 zamiast 204), a mimo to metoda jest idempotentna — bo idempotencja dotyczy efektu na serwerze, nie odpowiedzi. Po jednym i po dwóch wywołaniach linku nie ma, więc klient, który po zerwanym połączeniu ponowi DELETE i dostanie 404, może uznać sprawę za załatwioną.
POST jest odwrotny. Dwa identyczne żądania utworzyły u nas dwa różne linki z różnymi adresami. Jeśli połączenie zerwie się po wysłaniu POST, ślepe ponowienie może zostawić duplikat. Bezpieczniej najpierw pobrać listę linków (GET /api/v1/links) i sprawdzić, czy link do tego adresu już powstał. Nasz PATCH ustawia pola na konkretne wartości ("is_active": false), więc jego powtórzenie niczego nie psuje, ale to cecha naszej implementacji, nie metody — PATCH, który na przykład dopisuje element do listy, przy powtórzeniu dopisze go dwa razy.
Problem z POST próbuje rozwiązać nagłówek Idempotency-Key: klient nadaje żądaniu unikalny identyfikator, a serwer, widząc go drugi raz, nie wykonuje operacji ponownie. Szkic IETF opisuje go jako sposób, by metody nieidempotentne „such as POST or PATCH” stały się odporne na błędy (draft-ietf-httpapi-idempotency-key-header-07). To jednak szkic, który wygasł 18 kwietnia 2026 roku, nie standard. Nasze API go nie obsługuje — dlatego reguła „najpierw sprawdź” zostaje.
Kody odpowiedzi w REST API
Kod odpowiedzi to pierwsza rzecz, którą program powinien sprawdzić: mówi, czy się udało, a jeśli nie — po czyjej stronie leży problem. Kody 2xx to sukces, 4xx to błąd po stronie żądania, 5xx — po stronie serwera. W naszym API spotkasz te:
|
Kod |
Kiedy u nas |
Co zrobić |
|---|---|---|
|
200 |
odczyt ( |
przeczytać |
|
201 |
|
zapisać |
|
204 |
|
nic |
|
400 |
błąd walidacji ( |
poprawić żądanie, nie ponawiać bez zmian |
|
401 |
brak klucza, zły format, klucz nieznany, wyłączony albo wygasły |
sprawdzić klucz; ponowienie nic nie da |
|
403 |
klucz bez uprawnienia ( |
użyć klucza z właściwym zakresem |
|
404 |
zasobu nie ma, np. został już usunięty ( |
sprawdzić |
|
409 |
wybrany alias linku jest zajęty ( |
wybrać inny |
|
429 |
przekroczony limit zapytań |
odczekać |
Różnica między 401 a 403 bywa myląca. 401 znaczy „nie wiem, kim jesteś” — klucza nie ma albo jest nieważny. 403 znaczy „wiem, kim jesteś, ale tego ci nie wolno”. W pomiarze klucz z samym uprawnieniem links:read dostał przy próbie utworzenia linku 403 INSUFFICIENT_PERMISSIONS. Zakresy uprawnień i to, jak dobrać je do integracji, opisuje tekst o kluczu API.
Dwie grupy kodów mają własne teksty. Przekierowania 3xx — 301, 302, 307 i 308 — omawia artykuł o przekierowaniu 301; w API ważne jest tam to, że 301 i 302 mogą zamienić POST na GET. Kody 404 i 410, łącznie z tym, kiedy który wybrać, opisuje tekst o błędzie 404.
Limity zapytań i 429: jak to zrobić dobrze
Publiczne API ogranicza liczbę zapytań, żeby jeden klient nie zajął serwera innym. Na przekroczenie jest osobny kod: 429 Too Many Requests znaczy, że użytkownik wysłał „too many requests in a given amount of time”, a odpowiedź może zawierać nagłówek Retry-After z informacją, jak długo czekać (RFC 6585, §4). Retry-After to data albo liczba sekund (RFC 9110, §10.2.3).
Nasze API ma dwa limity na konto: godzinowy i minutowy. Na planie Starter to 100 zapytań na godzinę i 50 na minutę, na Pro 10 000 i 200, na Business 50 000 i 500. Wszystkie klucze konta dzielą ten sam limit. Po co dwa? Sam limit godzinowy pozwala zużyć całą godzinę w kilka sekund — limit minutowy rozkłada ruch w czasie. Oba liczymy w oknie przesuwnym: serwer patrzy na ostatnią minutę i ostatnią godzinę, a nie na pełne godziny zegarowe.
Sprawdziliśmy to na świeżym koncie Starter: 60 zapytań GET /api/v1/links jedno po drugim, potem czekanie tyle, ile kazał serwer, i dalsze zapytania aż do kolejnej odmowy.
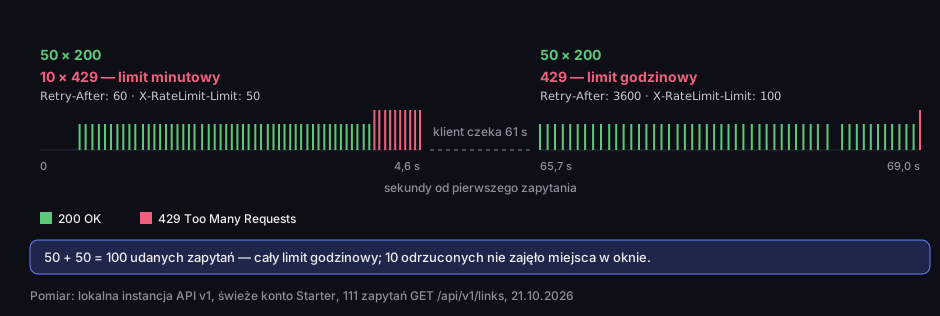
Limit zapytań w praktyce — plan Starter, 50 na minutę i 100 na godzinę
111 zapytań GET /api/v1/links na świeżym koncie, lokalna instancja
Pomiar: lokalna instancja API v1, świeże konto Starter, 21.10.2026
Opis figury
Oś czasu. Pierwsze 50 zapytań w ciągu około 4 sekund: 200 OK. Kolejne 10: 429, limit minutowy, nagłówki Retry-After: 60 i X-RateLimit-Limit: 50. Klient czeka 61 sekund. Potem 50 zapytań 200 OK i 429 przy limicie godzinowym, Retry-After: 3600, X-RateLimit-Limit: 100. Razem 50 plus 50, czyli 100 udanych zapytań — cały limit godzinowy; 10 odrzuconych nie zajęło miejsca w oknie.
Z pomiaru wynikają trzy praktyczne rzeczy. Pierwsza: przy 429 nasze API wysyła Retry-After oraz nagłówki X-RateLimit-Limit, X-RateLimit-Remaining i X-RateLimit-Reset. Zwykła udana odpowiedź ich nie ma — nie licz na nie, żeby śledzić zużycie na bieżąco. Druga: Retry-After podaje u nas pełną długość okna, 60 sekund dla limitu minutowego i 3600 dla godzinowego. To wartość z zapasem — w oknie przesuwnym miejsce może zwolnić się wcześniej — ale klient, który jej słucha, na pewno trafi w wolne okno.
Trzecia: odrzucone zapytanie nie zużywa limitu. Po 50 udanych i 10 odrzuconych przerwa wystarczyła, by przeszło kolejnych 50 — razem 100, czyli cały limit godzinowy — a następne zapytanie dostało 429 z Retry-After: 3600. Ponawianie przed upływem Retry-After limitu Ci więc nie odbiera, ale też niczego nie przyspiesza: zwykle kończy się kolejnym 429 i tylko dokłada ruchu. Właściwa reakcja na 429 to przeczytać Retry-After, odczekać i dopiero wtedy wysłać zapytanie ponownie.
Stronicowanie: numer strony czy kursor
Lista zasobów rzadko mieści się w jednej odpowiedzi, więc API dzieli ją na strony. Są dwa podejścia i nasze API używa obu, każdego tam, gdzie pasuje.
Lista linków ma numery stron. Parametry page i limit (od 1 do 100, domyślnie 20) idą w części adresu po znaku zapytania, np. GET /api/v1/links?page=2&limit=50, a odpowiedź poza data zawiera obiekt pagination z polami page, limit, total_pages, total_items i has_more. Gdy has_more jest false, to koniec. To proste i wystarcza, bo lista linków zmienia się rzadko.
Strumień zdarzeń — kliknięć i skanów — rośnie przez cały czas, więc numer strony by go psuł. Wyjaśnia to komentarz w naszym kodzie: przy stronicowaniu przez przesunięcie nowe zdarzenie, które przyjdzie między dwiema stronami, „shifts everything down”, a klient po cichu czyta któryś wiersz dwa razy albo jakiś pomija. Dlatego zdarzenia stronicujemy kursorem: odpowiedź zwraca next_cursor, czyli zakodowany czas i identyfikator ostatniego zdarzenia, a następne zapytanie prosi o wszystko „po nim”. Wynik jest stabilny bez względu na to, ile zdarzeń przybędzie w międzyczasie.
Reguła: numery stron dla zbiorów, które się nie przesuwają; kursor dla strumieni, przez które program przechodzi od początku do końca.
REST, SOAP czy GraphQL
REST nie jest jedynym sposobem budowania API, ale jest najczęstszym. Ankieta Postmana z 2025 roku pokazuje, z czego korzystają zespoły — można było wskazać kilka odpowiedzi:
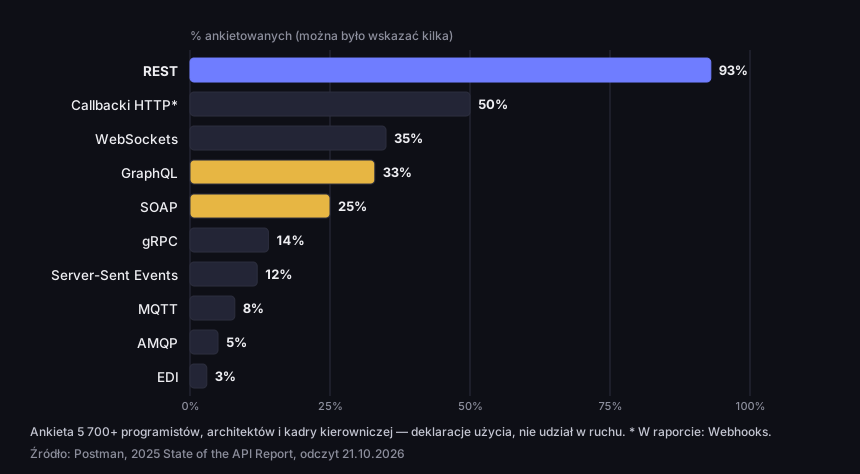
Z jakich stylów API korzystają zespoły (Postman 2025)
odsetek ankietowanych, wiele odpowiedzi
Źródło: Postman, 2025 State of the API Report, odczyt 21.10.2026
Opis figury
Wykres słupkowy. REST 93%, callbacki HTTP wysyłane przez serwer 50%, WebSockets 35%, GraphQL 33%, SOAP 25%, gRPC 14%, Server-Sent Events 12%, MQTT 8%, AMQP 5%, EDI 3%. Ankieta ponad 5700 programistów, architektów i menedżerów; to deklaracje użycia, nie udział w ruchu.
Trzy style najczęściej porównywane z REST różnią się zasadniczo:
|
Cecha |
REST |
SOAP |
GraphQL |
|---|---|---|---|
|
Czym jest |
styl architektury (Fielding, 2000) |
protokół wymiany komunikatów (W3C) |
język zapytań (specyfikacja GraphQL) |
|
Komunikat |
reprezentacja zasobu, zwykle JSON |
koperta XML ( |
odpowiedź najczęściej w JSON |
|
Kto decyduje o odpowiedzi |
serwer |
serwer, według kontraktu |
klient opisuje, jakich danych potrzebuje |
|
Opis interfejsu |
OpenAPI |
WSDL (język XML do opisu usług) |
schemat GraphQL |
SOAP to według specyfikacji W3C „a lightweight protocol intended for exchanging structured information in a decentralized, distributed environment” (W3C, SOAP 1.2). Używa technologii XML: każdy komunikat to koperta (Envelope) z opcjonalnym nagłówkiem i treścią, a usługę opisuje się w WSDL, czyli w języku XML do opisu usług sieciowych (W3C, WSDL 2.0). Jest wciąż w użyciu — w ankiecie Postmana korzysta z niego 25%.
GraphQL to „a query language designed to build client applications”, w którym klient sam opisuje, jakich danych potrzebuje (specyfikacja GraphQL, wrzesień 2025). W REST kształt odpowiedzi ustala serwer i dostajesz cały zasób; w GraphQL wymieniasz w zapytaniu dokładnie te pola, które chcesz, także z kilku powiązanych obiektów naraz. Korzysta z niego 33% ankietowanych.
W polskich poradnikach krąży twierdzenie, że REST jest „o X% szybszy” od SOAP — nie znaleźliśmy pomiaru, na którym by się opierało. Wybór praktyczny jest prostszy: REST dla publicznego API, z którego korzystają różne zespoły i narzędzia; SOAP, gdy wymaga go system, z którym się łączysz; GraphQL, gdy klient potrzebuje elastycznie łączyć wiele zasobów.
Dla API po HTTP standardem opisu jest OpenAPI: specyfikacja, która pozwala ludziom i programom poznać możliwości usługi „without requiring access to source code, additional documentation, or inspection of network traffic” (OpenAPI Specification 3.1.0). Nasze API ma taki plik w wersji 3.1.0, a z niego powstaje interaktywna dokumentacja, o której niżej.
Pierwsze wywołanie: REST API na przykładzie skracacza linków
Nasze API pozwala tworzyć, odczytywać, zmieniać i usuwać krótkie linki, pobierać ich kody QR i statystyki. Jest dostępne od planu Starter, a także w 7-dniowym okresie próbnym nowego konta; na planie Darmowym klucza nie utworzysz. Szczegóły planów są w cenniku.
Kroki są trzy. Najpierw załóż konto i w zakładce Ustawienia, w sekcji Klucze API, utwórz klucz. Serwer pokaże go tylko raz. Potem wyślij żądanie z kluczem w nagłówku Authorization:
1curl -i -X POST https://dvnlinks.pl/api/v1/links \2 -H "Authorization: Bearer $DVN_API_KEY" \3 -H "Content-Type: application/json" \4 -d '{"original_url": "https://example.com/oferta"}'Opcja -i pokaże kod i nagłówki odpowiedzi. Spodziewaj się 201 i obiektu data z polem short_url. Na koniec odczytaj link, który właśnie powstał, podstawiając jego id:
1curl https://dvnlinks.pl/api/v1/links/ID_LINKU \2 -H "Authorization: Bearer $DVN_API_KEY"Klucz trzymaj w zmiennej, nie w treści polecenia — nie zostanie w historii terminala. Starszy sposób przekazywania klucza w adresie (?api_key=) jeszcze działa, ale jest wycofywany: odpowiedź dostaje wtedy nagłówki Deprecation i Warning, bo adres z kluczem trafia do logów. Dlaczego to groźne i jak przechowywać klucz, opisuje tekst o kluczu API; klik po kliku w panelu — dokumentacja kluczy API.
Pełny opis wszystkich punktów końcowych jest w specyfikacji OpenAPI 3.1.0 i w interaktywnej dokumentacji pod adresem /api/reference, gdzie możesz wysyłać zapytania prosto z przeglądarki. Jak to samo wygląda w panelu, od konta po pierwszy link, pokazuje poradnik o pierwszych krokach; wprowadzenie do API jest też w dokumentacji. Czego API nie robi: nie wysyła powiadomień o kliknięciach na Twój serwer, nie tworzy stron bio ani kodów QR prowadzących do plików i nie ma operacji masowych — każdy link to osobne żądanie. Pełną listę funkcji znajdziesz na stronie funkcji.
Najczęstsze pytania
Umowa, przez którą jeden program korzysta z drugiego: jakie pytania wolno zadać i co wróci w odpowiedzi. W sieci zwykle przez HTTP.
API zbudowane według zasad REST: zasoby mają własne adresy, operacje to metody HTTP, a serwer nie trzyma stanu sesji. W praktyce „RESTful” i „REST API” oznaczają to samo — HTTP API w stylu REST — choć według Fieldinga bez hipermediów żadne z nich nie jest REST-em w pełnym sensie.
SOAP to protokół W3C z kopertą XML i kontraktem w WSDL; REST to styl oparty na HTTP, zwykle z JSON. SOAP wybierasz wtedy, gdy wymaga go system, z którym się łączysz.
Nie. Fielding mówi o reprezentacjach zasobu, a ich format to typ mediów: „The data format of a representation is known as a media type” (rozdz. 5). JSON to dziś zwyczaj, nie wymóg — to samo API mogłoby oddawać XML albo CSV.
Że wysłałeś za dużo zapytań w danym czasie. Odczytaj nagłówek Retry-After i odczekaj podaną liczbę sekund; ponawianie od razu zwykle kończy się kolejnym 429.
Chcesz zobaczyć REST API w działaniu na własnym koncie? Załóż konto, wygeneruj klucz i utwórz link jednym poleceniem curl — API jest dostępne od planu Starter i w okresie próbnym.