Adres URL: co to jest i z czego się składa
Adres URL krok po kroku: schemat, host, port, ścieżka, zapytanie i fragment. Ile znaków może mieć adres, co robią z nim polskie litery i dlaczego długi adres psuje kod QR.
Adres URL to tekst, który widzisz w pasku przeglądarki, na przykład https://dvnlinks.pl/cennik. Co to jest URL w jednym zdaniu? Adres zasobu w sieci, zapisany tak, żeby program wiedział, jak i skąd go pobrać. Mówi dwie rzeczy: jakim sposobem pobrać stronę (tu https) i skąd (z serwera dvnlinks.pl, spod ścieżki /cennik). Gdy formularz w sklepie, urzędzie albo panelu reklamowym prosi o „adres URL”, chodzi o ten tekst: kliknij w pasek adresu, zaznacz całość i skopiuj, a na telefonie użyj „Udostępnij” → „Kopiuj link”. Poniżej rozbieramy jeden prawdziwy adres na sześć części według normy, wyjaśniamy, czym URL różni się od URI, co polskie litery robią z długością adresu, ile znaków adres naprawdę może mieć (nie 2048) i ile kosztuje długi adres, gdy trafia do SMS-a albo kodu QR.
Adres URL — co to jest i skąd się wziął
URL to skrót od Uniform Resource Locator, czyli „jednolity lokalizator zasobu”. Jako proponowany standard internetowy URL opisano po raz pierwszy w grudniu 1994 roku w RFC 1738; jego redaktorami byli Tim Berners-Lee, twórca WWW, oraz Larry Masinter i Mark McCahill. Już tam adres ma postać <schemat>:<część zależna od schematu> — najpierw sposób dostępu, potem wszystko, czego ten sposób potrzebuje (RFC 1738).
Dzisiejszą składnię opisuje RFC 3986 ze stycznia 2005 roku, standard internetowy STD 66 (RFC 3986). Przeglądarki stosują jednak w praktyce inny dokument: URL Standard organizacji WHATWG, który powstał, żeby „Align RFC 3986 and RFC 3987 with contemporary implementations and obsolete the RFCs in the process” — dopasować normę do tego, jak przeglądarki naprawdę czytają adresy (WHATWG URL Standard). Różnice, które WHATWG wymienia, dotyczą m.in. spacji i innych „niedozwolonych” znaków, kodowania zapytania i porównywania adresów; przy zwykłym adresie strony rzadko mają znaczenie.
Jeden element adresu sam twórca uznaje za niezgrabny. Berners-Lee pisze w swoim FAQ: „I have to say that now I regret that the syntax is so clumsy” — dwa ukośniki po https: skopiował z systemu plików stacji Apollo, a skrót //www.example.com/foo „is rarely used and so we could dispense with the "//"” (Tim Berners-Lee, FAQ). Na zmianę było już za późno — i dlatego adresy stron zaczynają się od https://.
Pasek przeglądarki nie zawsze pokazuje adres w całości. Chrome, jak piszą jego wytyczne, często ukrywa subdomeny „www” i „m”, żeby uprościć adres (Chromium, URL Display Guidelines), a przeglądarki zwykle chowają też https://. Gdy klikniesz w pasek albo skopiujesz adres, dostaniesz jego pełną wersję — i tę wklejaj do formularza, nie przepisuj z tego, co widać na ekranie.
Z czego składa się adres URL: sześć części
Adres URL ma do sześciu części: schemat, host, port, ścieżkę, zapytanie i fragment. Norma pokazuje to na wzorcowym przykładzie foo://example.com:8042/over/there?name=ferret#nose (RFC 3986, §3); my rozbierzemy adres, jaki mógłby przyjść w newsletterze sklepu.
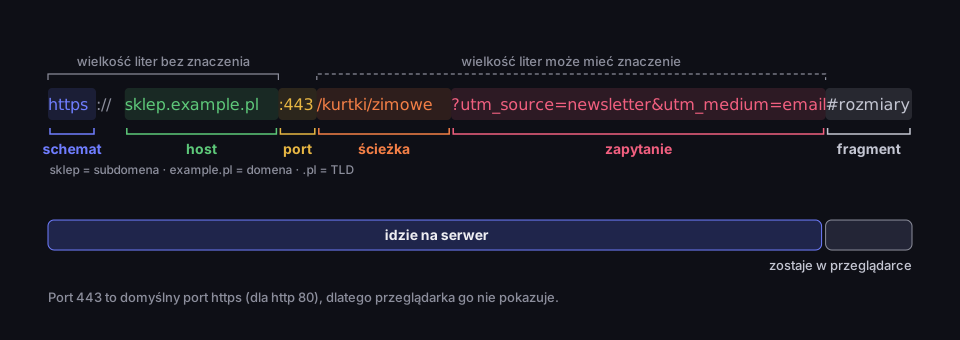
Anatomia adresu URL
sześć części jednego adresu i to, co trafia na serwer
Źródło: RFC 3986 §3, §3.5, §6.2.3; WHATWG URL Standard, odczyt 17.10.2026
Opis figury
Adres https://sklep.example.pl:443/kurtki/zimowe?utm_source=newsletter&utm_medium=email#rozmiary podzielony na części: schemat https, host sklep.example.pl (sklep to subdomena, example.pl to domena, .pl to TLD), port 443, ścieżka /kurtki/zimowe, zapytanie ?utm_source=newsletter&utm_medium=email i fragment #rozmiary. Wszystko przed # idzie na serwer, fragment zostaje w przeglądarce. W schemacie i hoście wielkość liter nie ma znaczenia, w ścieżce i zapytaniu może mieć. Port 443 to domyślny port https (dla http 80), dlatego przeglądarka go nie pokazuje.
Schemat (https) mówi, jakim protokołem pobrać zasób. Dziś na stronach to prawie zawsze https, czyli HTTP z szyfrowaniem; http bez „s” to połączenie nieszyfrowane. Ten sam zapis schemat: służy też do innych celów: mailto: otwiera program pocztowy, tel: — wybieranie numeru. Jak dopisać do linku mailto: temat i treść, opisujemy w tekście o linku mailto.
Host (sklep.example.pl) to nazwa serwera. Czyta się ją od prawej: .pl to domena najwyższego poziomu (TLD), example.pl to domena zarejestrowana przez właściciela, a sklep to subdomena, którą właściciel ustawił sam. Host może też być adresem IP.
Port (:443) to numer „drzwi” serwera. Każdy schemat ma port domyślny: 80 dla http i 443 dla https (WHATWG URL Standard). Norma wprost podaje, że http://example.com i http://example.com:80/ to ten sam adres (RFC 3986, §6.2.3), dlatego przeglądarka port domyślny ukrywa, a Ty widzisz go tylko wtedy, gdy serwer działa na innym, np. :8080.
Ścieżka (/kurtki/zimowe) wskazuje konkretną stronę lub plik na serwerze. Wygląda jak foldery, ale nie musi im odpowiadać — to serwer decyduje, co pokazać pod daną ścieżką.
Zapytanie (?utm_source=newsletter&utm_medium=email) zaczyna się od znaku zapytania i niesie dodatkowe dane jako pary klucz=wartość oddzielone &. Więcej o nim w osobnej sekcji niżej.
Fragment (#rozmiary) wskazuje miejsce na stronie, np. nagłówek, do którego przeglądarka ma przewinąć. To jedyna część, która nie trafia na serwer: norma mówi, że fragment jest obsługiwany „solely by the user agent” (RFC 3986, §3.5), a MDN dodaje wprost, że „is never sent to the server with the request” (MDN, What is a URL). Ma to praktyczny skutek: cokolwiek dopiszesz po #, serwer i narzędzia analityczne działające na serwerze tego nie zobaczą.
Czy wielkość liter w adresie ma znaczenie? Zależy od części. Schemat i host są niewrażliwe na wielkość liter — HTTPS://SKLEP.EXAMPLE.PL zaprowadzi tam samo. Dla pozostałych części norma zakłada odwrotnie: „assumed to be case-sensitive unless specifically defined otherwise by the scheme” (RFC 3986, §6.2.2.1). Google podaje przykład: /APPLE i /apple traktuje jako dwa różne adresy z osobną treścią (Google Search Central, URL structure). Czy konkretny serwer pokaże pod nimi to samo, zależy od serwera — dlatego bezpieczniej przepisywać ścieżkę dokładnie, litera w literę.
URL a URI (i URN): czym się różnią
URL to podzbiór URI. Norma definiuje URI (Uniform Resource Identifier) jako każdy identyfikator zasobu, a URL jako te URI, które „in addition to identifying a resource, provide a means of locating the resource by describing its primary access mechanism” — oprócz wskazania zasobu mówią, jak go pobrać (RFC 3986, §1.1.3). URN (Uniform Resource Name) to z kolei nazwa: identyfikator, który ma pozostać unikalny i trwały, nawet gdy zasób przestanie istnieć.
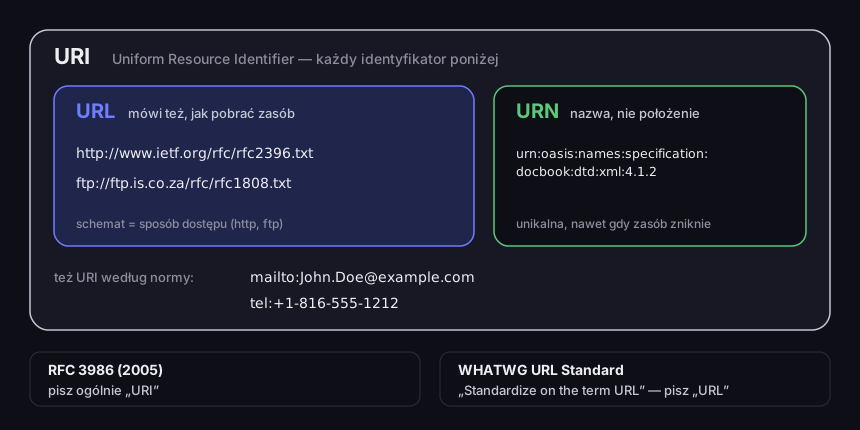
URI, URL i URN
przykłady z normy RFC 3986 i dwa stanowiska co do nazwy
Źródło: RFC 3986 §1.1.2, §1.1.3; WHATWG URL Standard, odczyt 17.10.2026
Opis figury
Zbiory zagnieżdżone. URI obejmuje URL (http://www.ietf.org/rfc/rfc2396.txt, ftp://ftp.is.co.za/rfc/rfc1808.txt — schemat to sposób dostępu) i URN (urn:oasis:names:specification:docbook:dtd:xml:4.1.2 — nazwa unikalna, nawet gdy zasób zniknie). mailto:[email protected] i tel:+1-816-555-1212 to też URI według normy. Pod spodem: RFC 3986 (2005) radzi pisać ogólnie URI; WHATWG URL Standard: Standardize on the term URL.
Przykłady z normy pokazują różnicę lepiej niż definicje. http://www.ietf.org/rfc/rfc2396.txt i ftp://ftp.is.co.za/rfc/rfc1808.txt to URL-e: schemat mówi, jakim protokołem pobrać plik. urn:oasis:names:specification:docbook:dtd:xml:4.1.2 to URN — nazywa specyfikację, ale nie mówi, skąd ją wziąć. mailto:[email protected] i tel:+1-816-555-1212 to URI, choć nikt nie nazwałby ich adresem strony (RFC 3986, §1.1.2).
Najczęstsze uproszczenie w sieci brzmi: „URI identyfikuje, URL lokalizuje”. To bliskie prawdy, ale norma idzie dalej i radzi w ogóle nie używać węższych nazw: „Future specifications and related documentation should use the general term "URI" rather than the more restrictive terms "URL" and "URN"” (RFC 3986, §1.1.3). WHATWG, którego standard stosują przeglądarki, przyjął odwrotne stanowisko: „Standardize on the term URL. URI and IRI are just confusing” (WHATWG URL Standard). Spór nie jest rozstrzygnięty i nie musisz go rozstrzygać. W codziennej mowie „adres URL”, „adres strony” i „link” znaczą to samo: tekst zaczynający się od https://.
Polskie znaki w adresie URL: percent-encoding i Punycode
Adres URL przesyłany przez sieć może zawierać tylko ograniczony zestaw znaków ASCII, więc polskie litery są kodowane — inaczej w ścieżce, inaczej w domenie. Przeglądarka pokazuje Ci wersję czytelną, ale do schowka, SMS-a i kodu QR trafia zwykle zakodowana.
W ścieżce i zapytaniu działa percent-encoding: każdy bajt znaku zapisuje się jako % i dwie cyfry szesnastkowe (RFC 3986, §2.1). Polska litera w UTF-8 zajmuje dwa bajty, więc z jednego znaku robi się sześć. Google zaleca to samo w linkach na stronach: „characters in the non-ASCII range should be percent encoded” (Google Search Central).
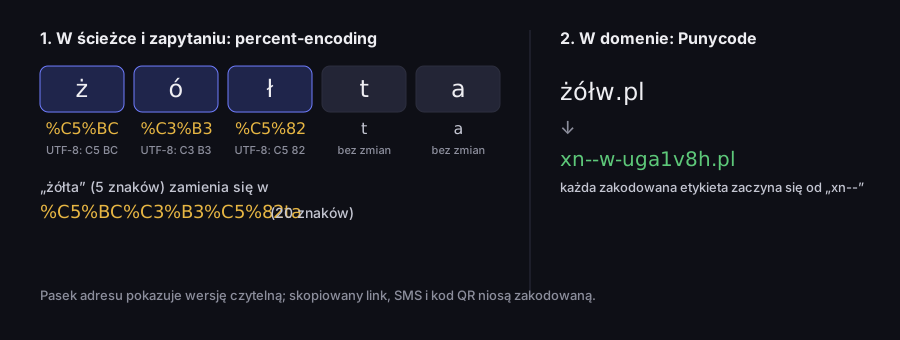
Co robią polskie litery w adresie
w ścieżce percent-encoding, w domenie Punycode
Źródło: RFC 3986 §2.1, RFC 3492, RFC 5890; nasze wyliczenie, WHATWG URL w Node, 17.10.2026
Opis figury
W ścieżce słowo żółta (5 znaków) jest kodowane bajt po bajcie w UTF-8: ż to %C5%BC, ó to %C3%B3, ł to %C5%82, t i a bez zmian — razem %C5%BC%C3%B3%C5%82ta, 20 znaków. W domenie żółw.pl zamienia się w xn--w-uga1v8h.pl (Punycode, każda zakodowana etykieta zaczyna się od xn--). Pasek adresu pokazuje wersję czytelną; skopiowany link, SMS i kod QR niosą zakodowaną.
Słowo żółta ma pięć liter, a po zakodowaniu %C5%BC%C3%B3%C5%82ta — dwadzieścia znaków. Policzyliśmy to parserem WHATWG w Node, tym samym algorytmem, którego używają przeglądarki. Dlatego link do strony /kurtki/żółta-kurtka wklejony w SMS-a wygląda jak ciąg procentów i liter, a odbiorca nie ma jak go przeczytać przed kliknięciem.
W domenie mechanizm jest inny. Nazwy domen z literami spoza ASCII zapisuje się kodem Punycode, który według normy „uniquely and reversibly transforms a Unicode string into an ASCII string” (RFC 3492). Zakodowana część domeny zaczyna się od xn-- (RFC 5890, §2.3.2.5). Przykładowa domena żółw.pl w sieci ma postać xn--w-uga1v8h.pl — to też nasze wyliczenie. Przeglądarka zwykle pokaże polskie litery, ale formularz, który nie obsługuje takich domen, przyjmie tylko wersję z xn--.
Wniosek dla właściciela strony jest prosty. W ścieżkach na swojej stronie pisz litery bez ogonków (zolta-kurtka), a słowa oddzielaj łącznikami, nie podkreśleniami — to też rada Google: „we recommend using hyphens (-) instead of underscores (\_)” (Google Search Central). Adres będzie krótszy, czytelny po skopiowaniu i taki sam w SMS-ie jak w pasku przeglądarki.
Parametry w adresie URL: co robi część po znaku zapytania
Parametry to pary klucz=wartość po znaku ?, które przekazują stronie dodatkowe dane: frazę z wyszukiwarki sklepu, numer strony listy, kolejność sortowania albo źródło wejścia. Kolejne pary łączy się znakiem &. Serwer albo skrypt na stronie czyta je i na tej podstawie decyduje, co pokazać lub co zapisać. W adresie https://sklep.example.pl/szukaj?q=kurtka&sort=cena&strona=2 są trzy parametry: szukana fraza, kolejność i numer strony wyników. Zmień strona=2 na strona=3, a serwer pokaże kolejną stronę listy. Parametr może też nieść tekst: w linku do WhatsAppa https://wa.me/48XXXXXXXXX?text=Pytanie%20o%20termin parametr text to gotowa wiadomość, którą WhatsApp wstawi w pole czatu — więcej w tekście o kodzie QR WhatsApp.
Parametry bywają też śladem po tym, skąd przyszedłeś. Link skopiowany z wyszukiwarki, newslettera albo portalu społecznościowego często ma doklejone identyfikatory kampanii lub kliknięcia. Zanim udostępnisz taki link dalej, spróbuj usunąć wszystko od ? — jeśli strona otwiera się tak samo, parametry nie były potrzebne, a link jest krótszy i nie niesie cudzych oznaczeń. Jeśli bez nich strona się zmienia (np. pokazuje inny produkt albo pustą wyszukiwarkę), zostaw je.
Najczęstszy przykład w marketingu to parametry UTM. Pomoc Google Analytics pokazuje wzór: https://www.example.com/?utm_source=summer-mailer&utm_medium=email&utm_campaign=summer-sale — strona jest ta sama, a GA4 zapisze, że wejście przyszło z mailingu kampanii „summer-sale”. Wartości rozróżniają wielkość liter: „utm_source=google is different from utm_source=Google” (Google Analytics, pomoc), więc w raportach zobaczysz dwa źródła zamiast jednego. Co znaczy każdy z parametrów i jak je nazywać, opisujemy w tekście o parametrach UTM.
Kolejność ma znaczenie w jednym miejscu: parametry muszą stać przed #. Fragment nie trafia na serwer, więc parametr dopisany za nim — …/kurtki#rozmiary?utm_source=newsletter — w ogóle nie dojdzie do analityki. To częsty błąd przy ręcznym doklejaniu UTM do linku, który już ma fragment. Jak kodować parametry, co z powtórzonymi kluczami i co się z nimi dzieje po przekierowaniu — w tekście o query stringu.
Dlatego nasz kreator UTM nie skleja tekstu, tylko składa adres parserem: wstawia parametry przed fragmentem, podmienia stare utm_*, jeśli wklejony link je miał, zostawia inne parametry na miejscu i ostrzega, gdy adres ma #. Dopisz UTM do swojego adresu w kreatorze — bez konta.
Parametrów nie warto mnożyć. Google radzi: „Whenever possible, shorten URLs by trimming unnecessary parameters (meaning, parameters that don't change the content)” (Google Search Central). Każdy parametr wydłuża adres, a długi adres ma swoją cenę. Nie wkładaj też w parametry niczego tajnego: adres razem z częścią po ? trafia do logów serwerów i historii przeglądarki — dlatego klucz API wysyła się w nagłówku, nie w adresie, o czym piszemy w tekście o kluczu API.
Jak długi może być adres URL
Popularna odpowiedź „maksymalnie 2048 znaków” myli źródło: 2048 to limit adresu w mapie witryny, nie w przeglądarce ani w protokole HTTP. Protokół mapy witryny mówi o polu <loc>: „This value must be less than 2,048 characters” (sitemaps.org, Protocol). Ta reguła dotyczy tylko pliku, w którym zgłaszasz strony wyszukiwarkom.
Sam HTTP górnej granicy nie ustala. Norma pisze, że „HTTP does not have specific length limitations for many of its protocol elements”, i zaleca, by programy obsługiwały adresy co najmniej do 8000 oktetów (bajtów) (RFC 9110, §4.1). Te 8000 to minimum, które serwer i przeglądarka powinny przyjąć, a nie maksimum, którego nie wolno przekroczyć. Chrome przyjmuje adresy do 2 MB, a granicę ustawił z powodów praktycznych, żeby zbyt długie adresy nie przeciążały komunikacji między procesami przeglądarki (Chromium, URL Display Guidelines).
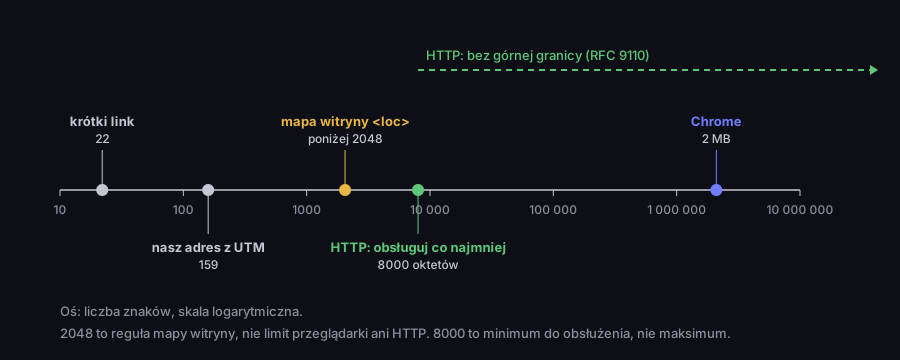
Ile znaków może mieć adres URL
limity na skali logarytmicznej, z naszym adresem dla porównania
Źródło: sitemaps.org; RFC 9110 §4.1; Chromium, URL Display Guidelines; odczyt 17.10.2026
Opis figury
Skala logarytmiczna długości adresu: krótki link 22 znaki, nasz adres z UTM 159, adres w mapie witryny poniżej 2048 znaków (sitemaps.org), HTTP zaleca obsługę co najmniej 8000 oktetów i nie ustala górnej granicy (RFC 9110), Chrome przyjmuje do 2 MB (Chromium). 2048 to reguła mapy witryny, nie limit przeglądarki ani HTTP.
W praktyce granicę wyznacza nie przeglądarka, tylko miejsce, w które adres wklejasz. Pole formularza może mieć własny limit znaków, długi link w mailu bywa łamany na dwie linie i przestaje działać, a SMS z długim adresem dzieli się na kilka wiadomości. Na wydruku długi adres trzeba przepisać, a w kodzie QR oznacza gęstszy kod.
DVN Links nie ustawia limitu długości adresu docelowego; jako cel przyjmuje adresy zaczynające się od http:// albo https://. Możesz więc skrócić adres z kompletem parametrów UTM bez przycinania go.
Długi adres w SMS-ie i w kodzie QR
Im dłuższy adres, tym gęstszy kod QR, bo kod musi zmieścić każdy znak. Sprawdziliśmy to na pięciu wersjach adresu tej samej strony: od krótkiego linku po stronę z polskimi literami w ścieżce i czterema parametrami UTM. Kody wygenerowaliśmy tą samą biblioteką, której używa nasz generator.
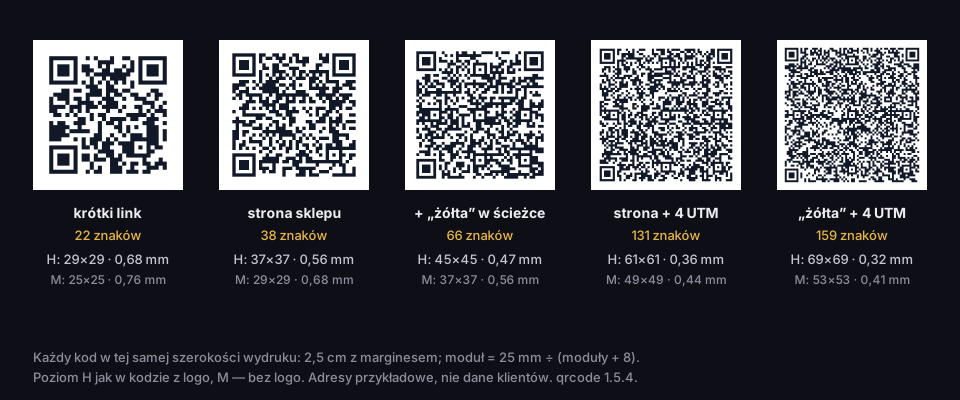
Ten sam cel, pięć adresów, pięć kodów QR
prawdziwe kody w jednej skali wydruku, 2,5 cm z marginesem
Źródło: nasze wyliczenie, qrcode 1.5.4, 17.10.2026
Opis figury
Pięć prawdziwych kodów QR w tej samej skali wydruku. Krótki link, 22 znaki: poziom H 29×29 modułów, moduł 0,68 mm; poziom M 25×25, 0,76 mm. Strona sklepu, 38 znaków: H 37×37, 0,56 mm; M 29×29, 0,68 mm. Z „żółta” w ścieżce, 66 znaków: H 45×45, 0,47 mm; M 37×37, 0,56 mm. Strona + 4 UTM, 131 znaków: H 61×61, 0,36 mm; M 49×49, 0,44 mm. „żółta” + 4 UTM, 159 znaków: H 69×69, 0,32 mm; M 53×53, 0,41 mm. Moduł = 25 mm ÷ (moduły + 8). Poziom H jak w kodzie z logo, M bez logo. Adresy przykładowe.
Krótki link https://qrln.pl/aB3xK9 ma 22 znaki. Pełny adres strony z polskimi literami w ścieżce i czterema parametrami UTM ma ich 159 — ponad siedem razy więcej. Kod z logo, a takie kody daje nasz darmowy generator, używa najwyższego poziomu korekcji błędów H; przy nim krótki link mieści się w kodzie 29×29 modułów, a długi adres potrzebuje 69×69. Wydrukowane w tym samym kwadracie 2,5 cm dają moduł 0,68 mm i 0,32 mm — ponad dwa razy mniejszy. Bez logo (poziom M) to 25×25 i 53×53 moduły.
Mniejszy moduł oznacza, że telefon musi podejść bliżej i gorzej radzi sobie przy słabym świetle albo zagiętej ulotce. Ile centymetrów drukować dla danej treści, liczymy krok po kroku w tekście o tym, dlaczego nie możesz zeskanować kodu QR.
Rozwiązaniem jest krótki link, który przekierowuje na pełny adres z parametrami: w kodzie i w SMS-ie siedzi 22 znaki, a parametry UTM docierają do analityki, bo przekierowanie przenosi pełny adres. Jak to zrobić i kiedy ma to sens, opisujemy w poradniku jak skrócić link. Jedno zastrzeżenie: na planie darmowym krótki link wygasa po 30 dniach, więc nie nadaje się na wydruk, który ma działać miesiącami. Link bez daty wygaśnięcia dają plany płatne — szczegóły w cenniku.
Jak przeczytać adres URL, zanim klikniesz
O tym, czyja jest strona, decyduje domena, a nie cały adres — i czyta się ją od prawej, przed pierwszym ukośnikiem. Wytyczne Chromium tłumaczą, że dla bezpieczeństwa liczy się „registrable domain”, czyli domena zarejestrowana przez właściciela, a pozostałe części adresu — subdomena, ścieżka, zapytanie — są w pełni pod kontrolą strony i mogą udawać inną markę. Przykład z wytycznych: adres https://not-really-paypal.com nie należy do PayPala, choć kończy się na „paypal.com” (Chromium, URL Display Guidelines). Domeną jest tu not-really-paypal.com, a nie paypal.com.
Ta sama zasada działa przy subdomenach: w paypal.com.weryfikacja-konta.example domeną jest weryfikacja-konta.example, a „paypal.com” na początku to dekoracja. Pułapki takie jak znak @ w adresie, litery z innego alfabetu i kłódka opisujemy w tekście o tym, jak sprawdzić, czy link jest bezpieczny.
Najczęściej zadawane pytania
Prawie. Link (odnośnik) to element strony albo wiadomości, w który klikasz; URL to adres, do którego ten link prowadzi. W codziennej mowie oba słowa znaczą to samo, a formularz proszący o „adres URL” chce po prostu tekstu zaczynającego się od https://.
Domena to tylko nazwa serwera, np. dvnlinks.pl. Adres URL to cały przepis na konkretną stronę: schemat, domena, ścieżka i ewentualnie parametry, np. https://dvnlinks.pl/cennik. Jeśli formularz prosi o domenę, wpisz samą nazwę; jeśli o adres URL — całość z https://.
W pasku przeglądarki nie musisz go wpisywać — przeglądarka dopisze schemat sama. W formularzach i narzędziach bywa inaczej: część z nich odrzuci adres bez schematu. Nasz kreator UTM dopisuje https://, gdy go brakuje, i pokazuje ostrzeżenie, żebyś wiedział, że adres został zmieniony.
W przeglądarce dotknij paska adresu u góry lub u dołu ekranu — pokaże się pełny adres do skopiowania. W aplikacjach, które paska nie mają, użyj przycisku „Udostępnij” i wybierz „Kopiuj link”.
W schemacie i domenie nie. W ścieżce i parametrach może mieć: norma zakłada, że ma, a Google traktuje /APPLE i /apple jako dwa różne adresy. Przepisuj ścieżkę dokładnie.
Nie, ale wydłużają adres. W ścieżce każda polska litera zamienia się w sześć znaków (ż → %C5%BC), a domena z polskimi literami ma postać zaczynającą się od xn--. Na swojej stronie lepiej używać liter bez ogonków.
HTTP jej nie ustala, a zaleca obsługę co najmniej 8000 znaków; Chrome przyjmuje do 2 MB. Limit 2048 znaków dotyczy tylko adresów w mapie witryny. W praktyce granicę wyznacza SMS, formularz albo kod QR, do którego adres wklejasz.