Błąd 404: co oznacza i jak naprawić martwy link
Błąd 404 znaczy, że pod adresem nic nie ma. Co zrobić jako odwiedzający, jak naprawić go na stronie i jak nie dopuścić do martwych linków w druku i kodach QR.
Błąd 404 oznacza, że serwer działa i odpowiedział, ale pod tym konkretnym adresem nie znalazł żadnej strony. Komunikat „404 Not Found” nie mówi więc, że internet się zepsuł ani że coś jest nie tak z Twoim telefonem. Mówi, że link prowadzi donikąd: ktoś przeniósł albo usunął stronę, w adresie jest literówka albo promocja, do której prowadził, dawno się skończyła. Dla odwiedzającego to zwykle ślepy zaułek, z którego da się wyjść w kilka sekund. Dla właściciela strony to sygnał, że gdzieś w sieci — w wynikach wyszukiwania, w mailu, na ulotce albo w kodzie QR na opakowaniu — wisi adres, który nikogo już nigdzie nie zaprowadzi. Poniżej wyjaśniamy, co dokładnie znaczy ten kod według specyfikacji HTTP, jak go traktuje Google, kiedy lepiej odpowiedzieć 410 albo przekierowaniem i co zrobić z martwym linkiem, którego nie da się poprawić, bo został wydrukowany.
Błąd 404 — co oznacza „404 Not Found”
Kod 404 to odpowiedź serwera na pytanie o adres, pod którym nic nie ma. Specyfikacja HTTP definiuje go tak: serwer „did not find a current representation for the target resource or is not willing to disclose that one exists” (RFC 9110, §15.5.5). Po polsku: nie znalazł obecnej wersji zasobu albo nie chce zdradzić, że on istnieje. Ta druga część nie jest przypadkowa — serwer, który chce ukryć istnienie strony, do której ktoś nie ma dostępu, może zamiast 403 odpowiedzieć właśnie 404 (RFC 9110, §15.5.4).
Ważniejsze jest to, czego kod 404 nie mówi. Według tej samej specyfikacji nie informuje, czy brak strony jest chwilowy, czy trwały. Jeśli serwer wie, że strona zniknęła na dobre, powinien raczej odpowiedzieć kodem 410 Gone (RFC 9110, §15.5.5). W praktyce 404 jest więc odpowiedzią domyślną: „nie ma, nie wiem, czy wróci”.
Pierwsza cyfra kodu mówi, po czyjej stronie leży problem. Kody 4xx to błędy żądania — klient poprosił o coś, czego serwer nie może dać. MDN opisuje 404 jako „client error response” i dodaje, że linki prowadzące na stronę 404 nazywa się „broken or dead links” (MDN, 404 Not Found). Kody 5xx to co innego: awaria po stronie serwera, który w ogóle nie potrafił obsłużyć zapytania. Przy 404 serwer działa poprawnie — po prostu nie ma czego pokazać. Dlatego strona z błędem 404 zwykle wygląda jak reszta serwisu, z menu i stopką, a przy błędzie 500 często widać goły komunikat. W API te same klasy kodów mówią programowi, co zrobić dalej — jak to wygląda w praktyce, pokazuje tekst o REST API.
„Błąd 404” to zresztą skrót myślowy. Dla serwera to nie awaria, tylko rzetelna odpowiedź. Błędem jest link, który do niej prowadzi.
Skąd się bierze błąd 404
Strony znikają z prozaicznych powodów. Najczęstsze to:
- zmieniony adres bez przekierowania — ktoś poprawił tytuł artykułu, a CMS przy okazji zmienił slug; stary adres w wynikach Google, w mailach i w linkach z innych stron prowadzi teraz donikąd;
- usunięta strona — wycofany produkt, zakończona oferta pracy, archiwalna aktualność;
- literówka w adresie — w linku w mailu, w poście albo na wydruku; tę ostatnią najtrudniej naprawić;
- wygasła promocja — specyfikacja HTTP podaje ją wręcz jako typowy przykład zasobu, który znika celowo (RFC 9110, §15.5.11);
- przeprowadzka serwisu — nowy CMS, nowa domena, nowa struktura adresów, a przekierowań brak albo obejmują tylko część stron.
Skala zjawiska jest większa, niż podpowiada intuicja. Pew Research Center sprawdziło w październiku 2023 r. strony z próby Common Crawl zapisane w latach 2013–2023. Ćwierć z nich nie była już dostępna, a wśród stron z 2013 r. — 38%; wśród stron z 2023 r. — 8% (Pew Research Center, 2024). Ten sam raport podaje, że co najmniej jeden martwy link ma 23% stron serwisów informacyjnych, 21% stron rządowych i 54% stron Wikipedii w sekcji przypisów. Dwa zastrzeżenia. Po pierwsze, to nie przekrój całego internetu: strony z lat 2013–2023 to losowa próba z archiwum Common Crawl, strony rządowe pochodzą z amerykańskich domen .gov, a Wikipedia to jej wersja anglojęzyczna. Po drugie, Pew liczyło stronę jako niedostępną tylko wtedy, gdy zwróciła jeden z dziewięciu kodów błędów albo nie odpowiedziała wcale. Strony, które odprawiały robota innym kodem, nie były liczone jako niedostępne — z tego samego powodu, z którego nasz monitoring nie alarmuje przy kodzie 403, o czym niżej.
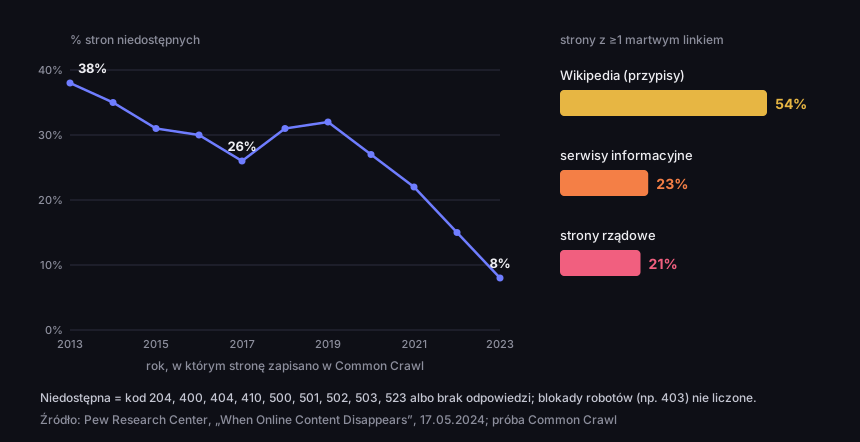
Ile stron zniknęło — odsetek niedostępnych w październiku 2023
według roku zapisu w Common Crawl, 2013–2023; obok strony z co najmniej jednym martwym linkiem
Źródło: Pew Research Center, „When Online Content Disappears”, 17.05.2024
Opis figury
Wykres liniowy i słupkowy. Odsetek stron niedostępnych w październiku 2023 według roku zapisu: 2013 — 38%, 2014 — 35%, 2015 — 31%, 2016 — 30%, 2017 — 26%, 2018 — 31%, 2019 — 32%, 2020 — 27%, 2021 — 22%, 2022 — 15%, 2023 — 8%. Słupki: strony z co najmniej jednym martwym linkiem — Wikipedia (przypisy) 54%, serwisy informacyjne 23%, strony rządowe 21%. Niedostępna oznacza kod 204, 400, 404, 410, 500, 501, 502, 503, 523 albo brak odpowiedzi.
Jeszcze wyraźniej widać to tam, gdzie link miał być trwałym przypisem. Zespół Jonathana Zittraina z Harvardu sprawdził w badaniu opublikowanym w 2014 r. adresy cytowane w czasopismach prawniczych i orzeczeniach Sądu Najwyższego USA: ponad 70% adresów w czasopismach i 50% w orzeczeniach nie prowadziło już do treści, którą pierwotnie cytowano (Harvard Law School, Zittrain, Albert, Lessig). To nie zawsze był błąd 404: autorzy liczyli też linki, które działały, ale pod którymi nie było już cytowanej treści albo zmieniła się ona (Harvard Law Review Forum, 2014). Wniosek jest jednak ten sam: link, którego nikt nie pilnuje, z czasem przestaje działać.
Co zrobić, gdy widzisz błąd 404
Jeśli trafiłeś na błąd 404 jako odwiedzający, prawie na pewno nie jest to Twoja wina, a odświeżanie strony nic nie da — serwer za drugim razem odpowie tak samo. Pomaga za to kilka prostych kroków:
- Sprawdź adres w pasku przeglądarki. Literówka, ucięta końcówka przy kopiowaniu, kropka albo nawias przyklejony do linku z wiadomości — to częste przyczyny. O tym, z czego składa się adres i która jego część za co odpowiada, piszemy w tekście o adresie URL.
- Skróć adres do domeny. Usuń wszystko po pierwszym ukośniku za nazwą domeny i wejdź na stronę główną; stamtąd zwykle da się dojść do szukanej treści przez menu albo wyszukiwarkę serwisu.
- Wyszukaj tytuł strony. Jeśli znasz tytuł artykułu albo nazwę produktu, wpisz je w wyszukiwarkę razem z nazwą serwisu — strona mogła zostać przeniesiona pod nowy adres.
- Zajrzyj do archiwum. Serwisy archiwizujące sieć, takie jak Wayback Machine, przechowują kopie części stron. Nie każda strona tam jest, a kopia może być stara — to ostatnia deska ratunku, nie gwarancja.
- Daj znać właścicielowi. Szczególnie gdy link pochodził z ulotki, opakowania albo kodu QR — właściciel często nie wie, że jego wydruk prowadzi donikąd.
Osobny przypadek to kod QR. Jeśli kod w ogóle się nie skanuje — aparat go nie widzi albo nic się nie dzieje — problem jest w druku: rozmiarze, kontraście, odległości. Opisujemy go w tekście nie mogę zeskanować kodu QR. Jeśli kod się skanuje, ale otwiera stronę z błędem 404, aparat zrobił wszystko dobrze — zawiódł adres zapisany w kodzie albo strona, na którą prowadzi. Ani ponowne skanowanie, ani inny telefon tego nie zmienią.
Jeśli strona w ogóle się nie otwiera — przekroczony czas, błąd certyfikatu, kod 502 albo 503 — to inna sytuacja niż 404: serwer nie działa albo nie da się do niego dotrzeć. Jak ustalić, czy to awaria u wszystkich, czy tylko u Ciebie, opisujemy w tekście strona nie działa.
404, 410 czy soft 404 — co widzi Google
Dla Google 404 i 410 znaczą to samo: treści nie ma. Dokumentacja Google Search Central mówi wprost, że wszystkie kody 4xx poza 429 są traktowane jednakowo — adres wypada z indeksu, jeśli w nim był, a nowo napotkanych stron 404 Google w ogóle nie przetwarza. Częstotliwość odwiedzin takiego adresu stopniowo maleje (Google Search Central, kody HTTP). Wyjątek to 429 i kody 5xx: dla robota znaczą „serwer jest przeciążony albo ma awarię”, więc Google tymczasowo zwalnia, zamiast usuwać strony.
Na polskich stronach o SEO krąży rada, że 410 „szybciej usuwa stronę z indeksu” niż 404. Dokumentacja Google tego nie mówi, a zdanie o jednakowym traktowaniu wszystkich 4xx raczej temu przeczy. Różnica między 404 a 410 jest semantyczna: 410 oznacza, że zasób zniknął celowo i prawdopodobnie na stałe (RFC 9110, §15.5.11). Specyfikacja dodaje, że nie ma potrzeby oznaczać kodem 410 wszystkiego, co zniknęło, a gdy serwer nie wie, czy brak jest trwały, powinien odpowiedzieć 404. MDN ilustruje 410 właśnie zakończoną promocją (MDN, 410 Gone).
Prawdziwym problemem jest soft 404 — „miękkie 404”. To strona, która wygląda jak błąd, ale serwer odpowiada na nią kodem 200, czyli „wszystko w porządku”. Search Console opisuje to tak: strona pokazuje przyjazny komunikat „nie znaleziono”, ale nie zwraca kodu 404, i zaleca zwracanie 404 dla stron, których naprawdę nie ma (Search Console, raport Indeksowanie stron). Soft 404 pojawia się też wtedy, gdy strona jest pusta albo zawiera tylko komunikat o błędzie (Google Search Central).
Drugie źródło soft 404 jest mniej oczywiste: przekierowanie wielu starych adresów na stronę główną. W poradniku o przenoszeniu serwisu Google prosi, żeby tego nie robić, bo to dezorientuje użytkowników i „might be treated as a soft 404 error” (Google Search Central, przenoszenie witryny). Ten sam poradnik zaleca, żeby usunięte strony na nowej witrynie zwracały 404 albo 410.
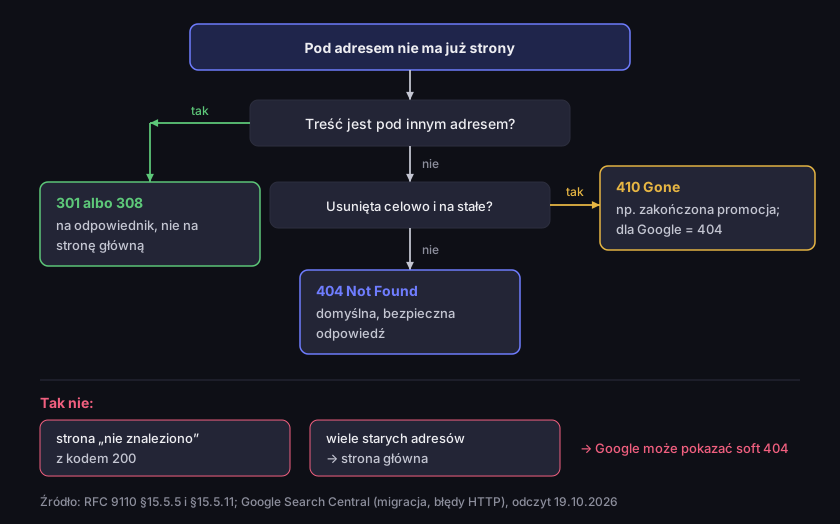
Strona zniknęła — co ma odpowiedzieć serwer
drzewo decyzji według RFC 9110 i dokumentacji Google
Źródło: RFC 9110 §15.5.5 i §15.5.11; Google Search Central, odczyt 19.10.2026
Opis figury
Drzewo decyzji. Pod adresem nie ma już strony. Czy treść jest pod innym adresem? Tak: przekierowanie 301 albo 308 na odpowiednik, nie na stronę główną. Nie: czy strona została usunięta celowo i na stałe? Tak: 410 Gone, na przykład zakończona promocja; Google traktuje to jak 404. Nie albo nie wiadomo: 404 Not Found, domyślna, bezpieczna odpowiedź. Poniżej dwa błędy: strona „nie znaleziono” z kodem 200 oraz przekierowanie wielu starych adresów na stronę główną — Google może je pokazać jako soft 404.
Czy sam błąd 404 szkodzi pozycjom strony? Google odpowiedział na to już w 2011 r.: błędy 404 to „a perfectly normal part of the web” — internet się zmienia, stare treści znikają, a znikająca strona powinna zwrócić 404 (Google Search Central Blog, 2011). W tym samym wpisie Google pisze, że woli prawdziwe 404 lub 410 od soft 404. Szkodą nie jest więc sam kod, tylko to, co tracisz: ruch z linków, które prowadziły na zniknięty adres, i odwiedzających, którzy odbili się od pustej strony.
Błąd 404 — jak naprawić na swojej stronie
Naprawa zaczyna się od pytania, co się stało z treścią. Jeśli jest pod innym adresem, ustaw przekierowanie stałe — 301 albo 308 — ze starego adresu na nowy. Search Console zaleca to wprost: strona przeniesiona — przekierowanie 301 na nowe miejsce, strona usunięta bez zastępstwa — 404 nie jest problemem (Search Console). Przekierowuj na odpowiednik, a nie na stronę główną: artykuł na nowy adres artykułu, produkt na następcę albo kategorię. Który kod przekierowania wybrać i jak go ustawić na serwerze, opisujemy w tekście o przekierowaniu 301.
Jeśli treść zniknęła i nie ma następcy, zostaw 404 albo — gdy wiesz, że to celowe i trwałe — daj 410. Nie próbuj „ratować” takich adresów przekierowaniem na stronę główną: odwiedzający szukał konkretnej rzeczy, a dostaje stronę, która jej nie zawiera, Google zaś może to uznać za soft 404.
Zadbaj o samą stronę błędu. Dobra strona 404 ma trzy cechy: zwraca prawdziwy kod 404 (nie 200), mówi po ludzku, że strony nie ma, i daje drogę dalej — menu, wyszukiwarkę, linki do najważniejszych działów. Większość CMS-ów pozwala ją ustawić w motywie; na serwerze Apache wskazuje się ją w pliku .htaccess (MDN). Kod odpowiedzi sprawdzisz poleceniem curl -I z adresem albo w narzędziach deweloperskich przeglądarki, w karcie Network.
Martwe adresy na własnej stronie znajdziesz w Google Search Console, w raporcie Indeksowanie stron: pozycja „Nie znaleziono (404)” pokazuje adresy, które robot odwiedził i dostał 404, a „Soft 404” — strony błędu z kodem 200. W tym samym raporcie są błędy przekierowań, czyli zbyt długie łańcuchy i pętle (Search Console). Search Console dodaje też, że nie da się kazać Googlebotowi na zawsze zapomnieć adresu — będzie go tylko odwiedzał coraz rzadziej. Pojedyncze stare 404 w raporcie nie są więc powodem do niepokoju.
Tak wygląda to u nas. Zmierzyliśmy, co odpowiadają nasze adresy w czterech sytuacjach: strona, której nigdy nie było, artykuł pod starym adresem, krótki link z kodem, którego nie ma, i strona dla wygasłych linków.
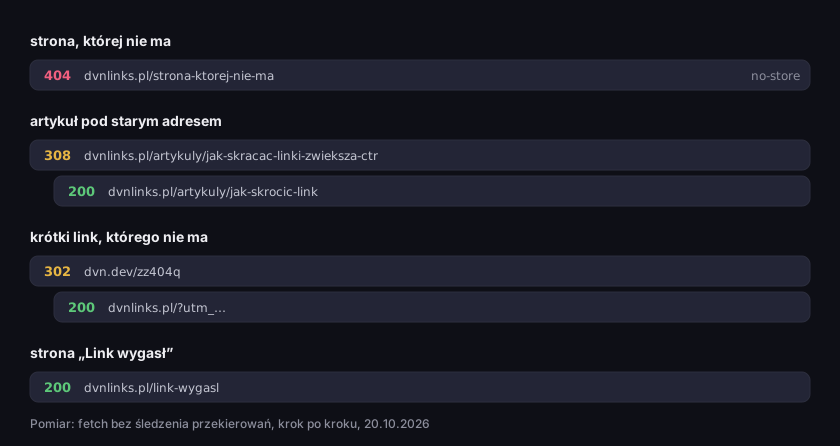
Brak strony a brak linku — co odpowiadają nasze adresy
każdy skok osobno, kod HTTP i adres
Źródło: pomiar DVN Links (fetch, krok po kroku), 20.10.2026
Opis figury
Cztery pomiary. Strona, której nie ma, dvnlinks.pl/strona-ktorej-nie-ma: 404 z nagłówkiem no-store. Artykuł pod starym adresem dvnlinks.pl/artykuly/jak-skracac-linki-zwieksza-ctr: 308 na nowy adres, potem 200. Krótki link, którego nie ma, dvn.dev/zz404q: jedno przekierowanie 302 na stronę główną dvnlinks.pl z parametrami UTM, potem 200. Strona „Link wygasł”: 200.
Nieistniejąca strona dostaje prawdziwe 404, a zmieniony adres artykułu — jedno przekierowanie 308 prosto na nowy adres, bez łańcucha. Krótkie linki działają inaczej, o czym w następnej sekcji.
Martwe linki w druku i kodach QR
Link w mailu można poprawić i wysłać jeszcze raz. Linku na ulotce, plakacie, opakowaniu czy w kodzie QR na wizytówce poprawić się nie da — wydruk już jest u ludzi. Jeśli w kodzie jest zapisany pełny adres strony, a ta strona zniknie, każdy skan będzie kończył się błędem 404 aż do przedruku. Typowy scenariusz: kod na ulotce prowadzi do strony letniej promocji, promocja się kończy, ktoś porządkuje serwis i usuwa stronę, a ulotki dalej leżą w punktach obsługi.
Rozwiązaniem jest warstwa pośrednia: krótki link między wydrukiem a stroną docelową. W kodzie jest zapisany krótki adres, a dopiero on przekierowuje na właściwą stronę. Gdy strona docelowa zniknie, zmieniasz cel krótkiego linku w panelu, a wydrukowany kod zaczyna prowadzić w nowe miejsce. W DVN Links krótki link przekierowuje kodem 302, czyli tymczasowym, więc przeglądarki nie zapamiętują starego celu i zmiana obejmuje każdy kolejny skan. Dlaczego skracacz powinien odpowiadać 302, a nie 301, opisujemy w poradniku jak skrócić link.
Dwie rzeczy, które warto wiedzieć o tym, co robi nasz skracacz, gdy link nie prowadzi nigdzie:
- Wygasły link nie daje 404. Od planu Starter krótkiemu linkowi możesz ustawić datę ważności. Kto go po niej otworzy, dostaje przekierowanie 302 na naszą stronę „Link wygasł”, która odpowiada kodem 200 i wyjaśnia, co się stało. Bez ustawionej daty link nie ma terminu ważności na żadnym planie.
- Nieistniejący kod też nie daje 404. Gdy ktoś wpisze albo zeskanuje kod, którego nie ma, odpowiadamy jednym przekierowaniem 302 na stronę główną serwisu, z parametrami
utm_campaign=not_found— w naszych statystykach widać dzięki temu, ile takich wejść jest i z której domeny przyszły. Google pisze, że przekierowanie wielu adresów na stronę główną może być uznane za soft 404. Robimy to świadomie: krótki adres nie ma pozycji w wynikach wyszukiwania, którą mógłby stracić, a człowiek, który zeskanował uszkodzony kod, trafia na działającą stronę zamiast na pusty błąd.
Zanim cokolwiek wydrukujesz, zeskanuj kod z próbnego wydruku telefonem i otwórz stronę do końca — nie tylko sprawdź, czy aparat rozpoznaje kod. Kod QR zrobisz w naszym generatorze kodów QR; jeśli ma prowadzić przez krótki link, utwórz link najpierw, a do kodu wpisz jego adres.
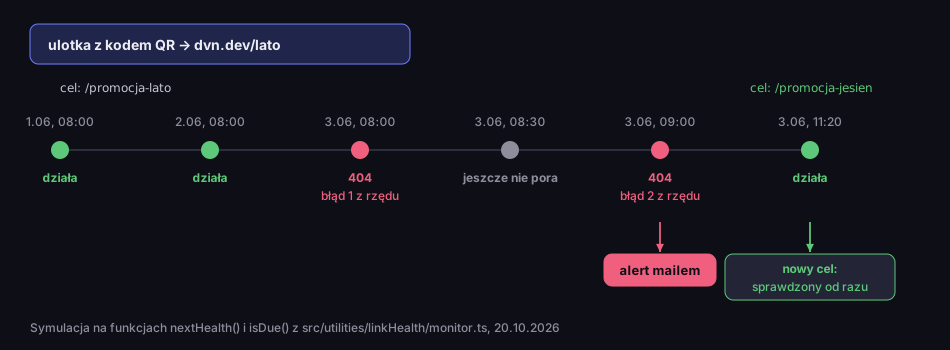
Wydrukowany kod QR, cel zwraca 404 — co robi monitoring
oś czasu z prawdziwej logiki monitoringu DVN Links
Źródło: symulacja na funkcjach monitoringu DVN Links (nextHealth, isDue), 20.10.2026
Opis figury
Oś czasu. Ulotka z kodem QR prowadzi do krótkiego linku dvn.dev/lato, a ten do strony /promocja-lato. 1 czerwca, 8:00 i 2 czerwca, 8:00: sprawdzenie raz dziennie, strona działa. 3 czerwca, 8:00: strona zwraca 404, pierwszy błąd z rzędu, bez alertu. 8:30: jeszcze nie pora na sprawdzenie. 9:00: 404, drugi błąd z rzędu — alert mailem. 11:20: właściciel zmienia cel na /promocja-jesien, nowy adres jest sprawdzony od razu i działa; wydrukowany kod prowadzi na nową stronę.
Jak automat sprawdza, czy link żyje (i czemu nie po jednym błędzie)
Zmiana celu pomaga tylko wtedy, gdy wiesz, że trzeba go zmienić. Dlatego od planu Pro DVN Links ma monitoring linków: raz dziennie sprawdza adres docelowy każdego aktywnego krótkiego linku i pisze maila, gdy strona przestanie działać. W planach Business i Enterprise dochodzi cotygodniowy raport. Plan Darmowy i Starter monitoringu nie mają — szczegóły są w cenniku, a opis funkcji na stronie funkcji. Jedno zastrzeżenie: monitoring pilnuje celów Twoich krótkich linków, a nie linków na Twojej stronie — to nie jest crawler, który przeszukuje serwis w poszukiwaniu martwych odnośników. Sprawdza też tylko adres domyślny linku, bez celów reguł i wariantów testu A/B, i pomija linki do plików, które trzymamy u siebie.
Budując go, musieliśmy rozstrzygnąć kilka rzeczy, które dotyczą każdego automatu sprawdzającego linki:
- HEAD, a w razie odmowy GET. Monitor najpierw pyta metodą HEAD — o same nagłówki, bez pobierania strony. Część serwerów obsługuje HEAD inaczej niż zwykłe wejście, więc przy odpowiedzi 403, 405 albo 501 pytamy jeszcze raz metodą GET.
- Przekierowania krok po kroku, najwyżej pięć. Każdy skok sprawdzamy osobno, także pod kątem tego, czy nie prowadzi do sieci prywatnej. Szósty skok z rzędu oznacza dla nas „za dużo przekierowań”. Limit pięciu to nawiązanie do dawnej wersji specyfikacji HTTP, która go zalecała; obecna przypomina, że część klientów nadal może mieć taki stały limit (RFC 9110, §15.4).
- 401, 403 i 429 to nie martwa strona. Wiele serwisów nie wpuszcza automatów: wymaga logowania, odrzuca nieznane programy albo ogranicza liczbę zapytań. Taka odpowiedź mówi coś o robocie, nie o stronie — człowiek w przeglądarce zobaczyłby ją normalnie. Oznaczamy to jako „nie da się sprawdzić” i nie wysyłamy alertu. Pew Research Center przyjęło tę samą ostrożność: liczyło stronę jako niedostępną tylko przy dziewięciu kodach błędów, bo wiele serwisów aktywnie blokuje automatyczne zbieranie danych (Pew Research Center).
- Niedziałająca strona to 404, 410, inne błędy 4xx i 5xx, nieistniejąca domena, nieważny certyfikat, odrzucone połączenie i brak odpowiedzi w ciągu 10 sekund. Gdy adres końcowy jest na liście Google Safe Browsing, monitoring oznacza go jako niebezpieczny — o tym, co ta lista wychwytuje, piszemy w tekście jak sprawdzić, czy link jest bezpieczny.
Sprawdziliśmy to na prawdziwej funkcji monitoringu, puszczając ją na serwer testowy, który odpowiadał w trzynastu wariantach.
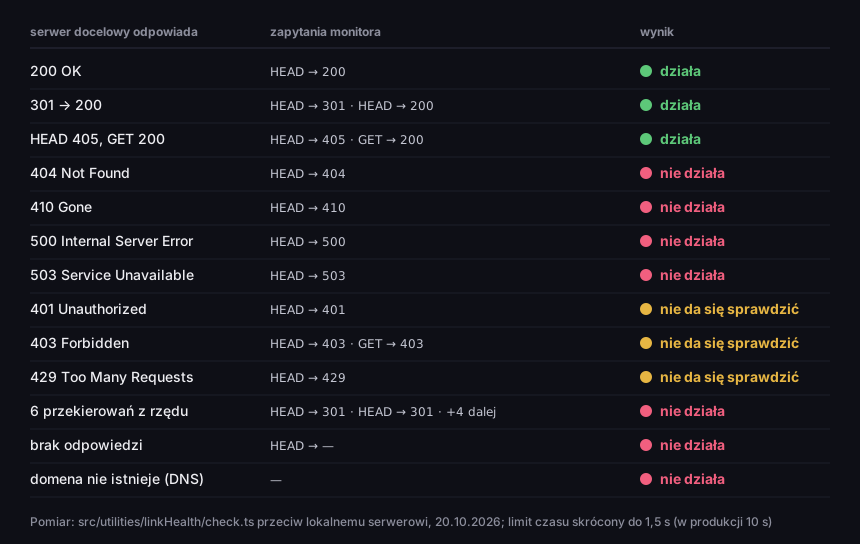
Jak monitoring linków ocenia odpowiedź strony docelowej
13 wariantów odpowiedzi, zapytania monitora i wynik
Źródło: pomiar DVN Links — funkcja sprawdzająca monitoringu przeciw lokalnemu serwerowi testowemu, 20.10.2026
Opis figury
Tabela trzynastu wariantów. 200 OK: jedno zapytanie HEAD, działa. 301 na stronę z 200: dwa zapytania HEAD, działa. HEAD 405, GET 200: HEAD, potem GET, działa. 404, 410, 500 i 503: jedno zapytanie HEAD, nie działa. 401 i 429: jedno zapytanie HEAD, nie da się sprawdzić. 403: HEAD i GET, nie da się sprawdzić. Sześć przekierowań z rzędu: sześć zapytań HEAD, nie działa (za dużo przekierowań). Brak odpowiedzi: nie działa (przekroczony czas). Domena nie istnieje: bez zapytania HTTP, nie działa.
Ostatnia decyzja dotyczyła tego, kiedy zaalarmować. Jeden nieudany test to za mało: serwer mógł się akurat restartować, a sieć — chwilowo zawieść. Dlatego gdy strona nie działa, monitor sprawdza ją ponownie po godzinie, a mail wysyła dopiero po drugim błędzie z rzędu. Wyjątkiem jest stan „niebezpieczny” — o nim piszemy od razu. Gdy zmienisz cel linku, nowy adres nie czeka na dobowy termin — trafia do kolejki od razu, a monitoring rusza co pięć minut — i jego historia zaczyna się od zera. Wysyłamy najwyżej jeden mail dziennie, w którym zbieramy wszystkie linki z problemem, a po naprawie — mail z informacją, że strona znowu działa. W panelu przy każdym linku widać kropkę stanu: działa, nie da się sprawdzić, nie działa albo niebezpieczny.
Najczęstsze pytania
Że serwer działa, ale pod tym adresem nie znalazł strony. Kod nie mówi, czy brak jest chwilowy, czy trwały, i nie oznacza awarii serwera — to odpowiedź na pytanie o adres, którego nie ma (RFC 9110).
Sam kod nie. Google nazywa błędy 404 normalną częścią sieci i usuwa takie adresy z indeksu (Google Search Central Blog). Tracisz za to ruch z linków, które prowadziły na zniknięty adres — jeśli treść jest gdzie indziej, ustaw przekierowanie 301.
To samo co na komputerze: sprawdź adres, skróć go do domeny, poszukaj strony w wyszukiwarce. Jeśli adres pochodzi z kodu QR, telefon odczytał go poprawnie — błąd jest w adresie albo na stronie, więc najlepiej zgłosić go właścicielowi kodu.
410, gdy wiesz, że strona zniknęła celowo i na stałe, na przykład po zakończonej promocji. W razie wątpliwości 404. Dla Google oba kody działają tak samo (Google Search Central).
Na własnej stronie — w Google Search Console, w raporcie Indeksowanie stron, pozycja „Nie znaleziono (404)”. W krótkich linkach i kodach QR, które rozdałeś albo wydrukowałeś, pilnuje ich monitoring linków DVN Links od planu Pro — zobacz cennik.