REST-API erklärt: mit einem echten Praxisbeispiel
Was eine REST-API ist – von Fieldings sechs Einschränkungen bis zu Methoden, Statuscodes, Rate Limits und Paginierung – gezeigt an einer laufenden API mit echten Antworten.
Eine REST-API ist der Weg, auf dem ein Programm über HTTP mit einem anderen spricht – demselben Protokoll, mit dem Ihr Browser Webseiten lädt. Die URL zeigt auf eine Ressource, etwa einen einzelnen Link in einem Link-Kürzer; die HTTP-Methode sagt, was damit geschehen soll (GET liest, POST legt an, DELETE löscht); und der Server antwortet mit einem Statuscode und Daten, meist als JSON. REST selbst ist weder ein Protokoll noch eine Bibliothek, sondern ein Architekturstil, den Roy Fielding im Jahr 2000 in seiner Dissertation beschrieben hat. Dieser Leitfaden beginnt bei der Quelle: Fieldings sechs Einschränkungen und die Frage, warum nach Meinung ihres Urhebers die meisten „REST-APIs“ gar keine sind. Danach geht es in die Praxis, an der laufenden API des Kurzlink-Dienstes DVN Links: echte Anfragen und Antworten, welche Anfragen sich gefahrlos wiederholen lassen, was 401, 403 und 429 bedeuten und wie sich ein Rate Limit verhält – Anfrage für Anfrage gemessen.
Was ist eine API – und was macht sie zur REST-API?
Eine API (Application Programming Interface, auf Deutsch Programmierschnittstelle) ist ein Vertrag zwischen Programmen: Welche Fragen darf das eine Programm dem anderen stellen, wie formuliert es sie, und was kommt zurück? Eine Benutzeroberfläche ist für Menschen gemacht – Schaltflächen und Formulare. Eine API ist für Software gemacht. Wenn ein Onlineshop den Sendungsstatus bei einem Paketdienst abfragt oder ein Mailing-Tool für jeden Newsletter einen Kurzlink anlegt, geschieht das über die API des Anbieters, ohne dass jemand ein Dashboard anklickt.
Im Web laufen APIs meist über HTTP, und hier kommt das Wort REST ins Spiel. MDN, die von Mozilla gepflegte Referenz, beschreibt die Lage ehrlich: HTTP-APIs würden allgemein umgangssprachlich als RESTful APIs bezeichnet, obwohl sie „nicht unbedingt allen REST-Beschränkungen folgen“, und Einsteiger könnten davon ausgehen, dass eine REST-API ein HTTP-Dienst ist, der sich mit gängigen Web-Bibliotheken und -Werkzeugen aufrufen lässt (MDN, REST, deutsche Fassung). Das ist eine brauchbare Arbeitsdefinition. „RESTful“ bedeutet in der Praxis dasselbe: eine API, die nach REST-Prinzipien entworfen ist – soweit die Branche sie anwendet.
In der Umfrage von Postman aus dem Jahr 2025 unter mehr als 5.700 Entwicklern, Architekten und Führungskräften nutzen 93 % der Befragten REST (Postman, 2025 State of the API Report, auf Englisch). Das sind Angaben zur Nutzung, kein Anteil am Datenverkehr – ein Team kann mehrere Stile gleichzeitig einsetzen.
REST-API-Einschränkungen: Fieldings sechs Regeln
REST ist ein Satz von Einschränkungen, die Fielding der Architektur eines vernetzten Systems auferlegt. Sein zentraler Gedanke ist die Ressource: „Die zentrale Abstraktion von Information in REST ist eine Ressource“ – alles, was sich benennen lässt, vom Dokument bis zum Bild (R. Fielding, Dissertation, Kap. 5, auf Englisch; Zitate aus englischen Quellen sind hier sinngemäß übersetzt). In der API eines Link-Kürzers ist die Ressource ein Link, und sein Name ist die Adresse /api/v1/links/{id}. Es gibt sechs Einschränkungen, und jede lässt sich an einer echten API überprüfen:
- Client-Server. Die Schnittstelle trennt den Client von der Datenspeicherung, sodass sich beide Seiten unabhängig voneinander weiterentwickeln können. Fielding betont, dass die Trennung es den Komponenten erlaubt, sich „unabhängig zu entwickeln“. Unsere Integrationen wissen nichts vom Dashboard oder von der Datenbank – sie sehen URLs und JSON.
- Zustandslosigkeit. Jede Anfrage muss alles enthalten, was der Server zu ihrem Verständnis braucht, und darf „keinen auf dem Server gespeicherten Kontext nutzen“; der Sitzungszustand bleibt beim Client. Deshalb kennt unsere API weder Login noch Session: Der Schlüssel reist mit jeder Anfrage mit.
- Cache. Daten in einer Antwort müssen als wiederverwendbar oder nicht wiederverwendbar gekennzeichnet sein. Unsere OpenAPI-Spezifikation kommt mit
Cache-Control: public, max-age=3600zurück, Antworten mit Link-Daten tragen jedoch gar keine Kennzeichnung – diese Einschränkung ist also nur teilweise erfüllt. - Einheitliche Schnittstelle. Für Fielding unterscheidet sie REST am deutlichsten von anderen Stilen. Sie besteht aus vier Einschränkungen: Identifikation von Ressourcen, Manipulation von Ressourcen über Repräsentationen, selbstbeschreibende Nachrichten und „Hypermedia als Motor des Anwendungszustands“, kurz HATEOAS.
- Schichtensystem. Eine Komponente kann nicht über die Schicht hinaussehen, mit der sie unmittelbar spricht. Antworten von dvnlinks.pl tragen den Header
server: cloudflare– zwischen Client und unserem Server sitzt ein CDN, und der Client muss davon nichts wissen. - Code on Demand. Der Server darf den Client erweitern, indem er Code zur Ausführung schickt. Fielding nennt das „eine optionale Einschränkung“ – die einzige optionale. Wir nutzen sie nicht.
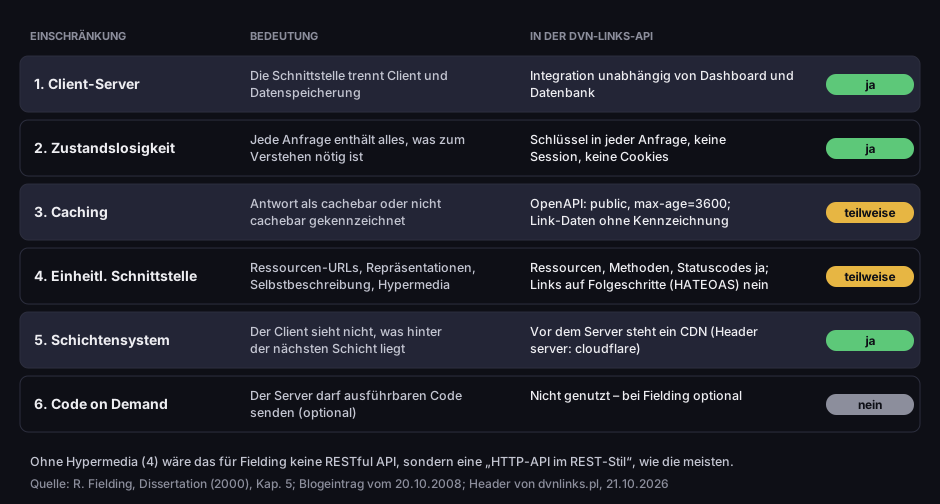
Fieldings sechs REST-Einschränkungen – und wie unsere API abschneidet
Was jede Einschränkung bedeutet und ob die DVN-Links-API sie erfüllt
Quelle: R. Fielding, Dissertation (2000), Kap. 5; Blogeintrag vom 20. Okt. 2008; Header von dvnlinks.pl, 21. Okt. 2026
Abbildungsbeschreibung
Tabelle mit sechs Einschränkungen. Client-Server: Die Schnittstelle trennt den Client von den Daten; bei uns ja. Zustandslosigkeit: Jede Anfrage enthält alles Nötige; bei uns ja, der Schlüssel steckt in jeder Anfrage. Cache: Eine Antwort ist als cachebar oder nicht cachebar gekennzeichnet; bei uns teilweise, die OpenAPI-Spezifikation mit public, max-age=3600, Link-Daten ohne Kennzeichnung. Einheitliche Schnittstelle: Ressourcen, Repräsentationen, selbstbeschreibende Nachrichten, Hypermedia; bei uns teilweise, kein HATEOAS. Schichtensystem: bei uns ja, davor ein CDN, Header server: cloudflare. Code on Demand: optional, bei uns nein.
Bei der vierten Einschränkung scheitern fast alle „REST-APIs“. HATEOAS bedeutet, dass die Antwort eines Servers Links auf die nächsten möglichen Schritte enthält und der Client ihnen folgt, so wie ein Mensch auf einer Webseite Links folgt – statt URLs aus der Dokumentation zu kennen. Fielding hat dazu 2008 einen eigenen Beitrag geschrieben. Er beginnt mit „Ich bin frustriert über die Zahl der Leute, die jede HTTP-basierte Schnittstelle als REST-API bezeichnen“, und er schließt, dass das Ganze „nicht RESTful sein und keine REST-API sein kann“, wenn der Motor des Anwendungszustands nicht von Hypertext angetrieben wird (R. Fielding, 20. Oktober 2008, auf Englisch).
Unsere API erfüllt diese Bedingung nicht: Eine Antwort mit einem Link verrät nicht, wo man ihn bearbeiten oder löschen kann – das Programm kennt diese URLs, weil es die Dokumentation gelesen hat. Im strengen Sinn Fieldings ist sie eine „HTTP-API im REST-Stil“, wie die meisten Schnittstellen, die sich so nennen. Für eine Integration spielt das keine Rolle, es erklärt aber die immer wiederkehrende Debatte „Ist das wirklich REST?“.
Aufbau von Anfrage und Antwort
Jeder Aufruf einer REST-API besteht aus einem Paar HTTP-Nachrichten: einer Anfrage und einer Antwort. Eine Anfrage hat vier Teile:
- die Methode – was getan werden soll (
GET,POST,PATCH,DELETE); - die Ressourcen-URL – woran es getan werden soll (
/api/v1/linksist die Sammlung der Links,/api/v1/links/{id}ein einzelner Link); wie eine URL aufgebaut ist, auch die Parameter hinter dem Fragezeichen, erklärt unser Leitfaden Was ist eine URL; - Header – Angaben zur Anfrage: wer fragt (
Authorization) und in welchem Format der Body vorliegt (Content-Type: application/json); - der Body – zu speichernde Daten, beim Lesen meist leer.
Eine Antwort besteht aus einem Statuscode (drei Ziffern), Headern und einem Body. So sieht das Anlegen eines Kurzlinks in unserer API aus – Anfrage und Antwort, aufgezeichnet an einer lokalen Instanz desselben Codes, der in der Produktion läuft:
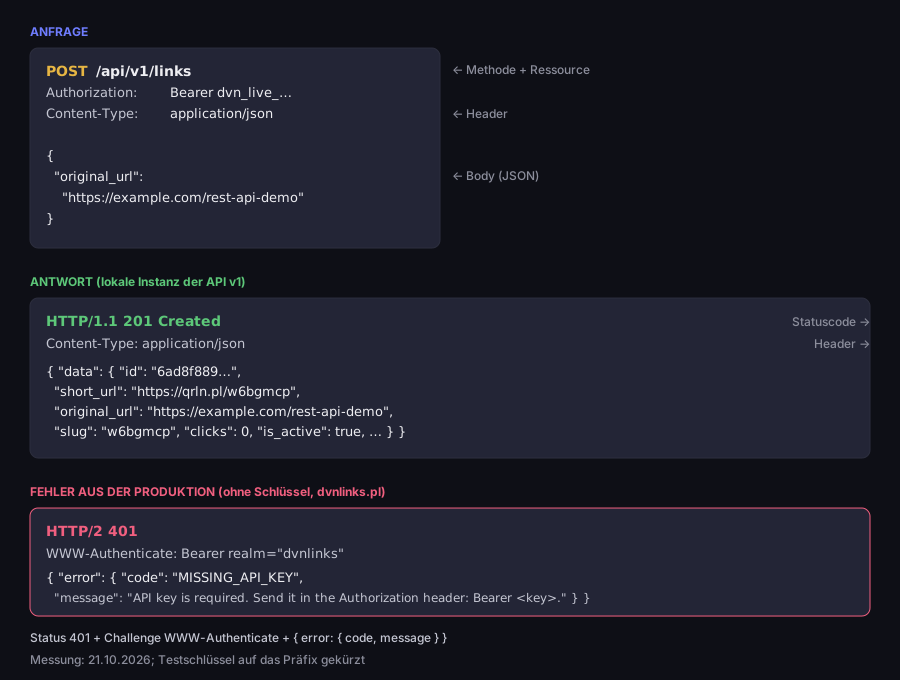
Aufbau eines REST-API-Aufrufs – Anfrage, Antwort, Fehler
POST /api/v1/links an einer lokalen Instanz; ein 401 aus der Produktion, ohne Schlüssel
Gemessen: lokale Instanz der API v1 und dvnlinks.pl, 21. Okt. 2026; Testschlüssel auf das Präfix gekürzt
Abbildungsbeschreibung
Anfrage POST /api/v1/links mit den Headern Authorization: Bearer dvn*live*… und Content-Type: application/json und dem Body {"original_url": "https://example.com/rest-api-demo"}. Antwort HTTP 201 Created, Content-Type: application/json, ein data-Body mit id, short_url auf der Domain qrln.pl, original_url, slug, clicks 0 und is_active true. Darunter die Antwort der Produktion von dvnlinks.pl ohne Schlüssel: HTTP 401, Header WWW-Authenticate: Bearer realm="dvnlinks", ein error-Body mit dem Code MISSING_API_KEY und einer Meldung zum Authorization-Header.
Zwei Dinge an dieser Abbildung gelten für jede API. Erstens haben Antworten eine feste Form: Daten stehen immer in einem data-Objekt, ein Fehler immer in error mit code und message. Ein Programm prüft zuerst den Statuscode und dann error.code – eine stabile Kennung, anders als die für Menschen geschriebene Meldung. Ein Validierungsfehler ergänzt details.field. Wer {"original_url": "not-a-url"} sendet, erhält 400 VALIDATION_ERROR mit "field": "original_url".
Zweitens ist ein 401 mehr als eine Zahl. Die HTTP-Spezifikation sagt, dass ein Server, der 401 sendet, „MUSS“ ein Header-Feld WWW-Authenticate mit mindestens einer Challenge senden, also einer Beschreibung, wie man sich authentifiziert (RFC 9110, §15.5.2, auf Englisch). Unsere API liefert WWW-Authenticate: Bearer realm="dvnlinks" und ergänzt error="invalid_token", wenn ein Schlüssel abgelehnt wird – ob fehlerhaft, unbekannt, deaktiviert oder abgelaufen. Wir haben das am 21. Oktober 2026 in der Produktion geprüft, ohne Schlüssel und mit einem fehlerhaften.
HTTP-Methoden: Welche Anfragen sich wiederholen lassen
HTTP-Methoden unterscheiden sich nicht nur darin, was sie tun, sondern auch darin, ob man eine Anfrage zweimal senden darf. Das ist wichtig, wenn die Verbindung abreißt, bevor der Client die Antwort liest: Man weiß dann nicht, ob der Server überhaupt etwas getan hat.
Die HTTP-Spezifikation definiert zwei Eigenschaften. Eine sichere Methode ist eine, deren Semantik „im Wesentlichen schreibgeschützt“ ist – der Client erwartet keine Änderung auf dem Server; GET ist so eine Methode (RFC 9110, §9.2.1, auf Englisch). Eine idempotente Methode ist eine, bei der mehrere identische Anfragen dieselbe Wirkung haben wie eine einzige. Die RFC nennt PUT, DELETE und die sicheren Methoden und erklärt, wozu die Unterscheidung dient: Eine solche Anfrage „kann automatisch wiederholt werden, wenn ein Kommunikationsfehler auftritt, bevor der Client die Antwort des Servers lesen kann“ (RFC 9110, §9.2.2, auf Englisch).
In Anleitungen heißt es manchmal, „PUT und PATCH sind idempotent“. Die PATCH-Spezifikation sagt etwas anderes: „PATCH ist weder sicher noch idempotent“, auch wenn sich eine PATCH-Anfrage so formulieren lässt, dass sie es ist (RFC 5789, §2, auf Englisch). Wir haben jede Anfrage zweimal hintereinander an eine lokale Instanz unserer API gesendet:
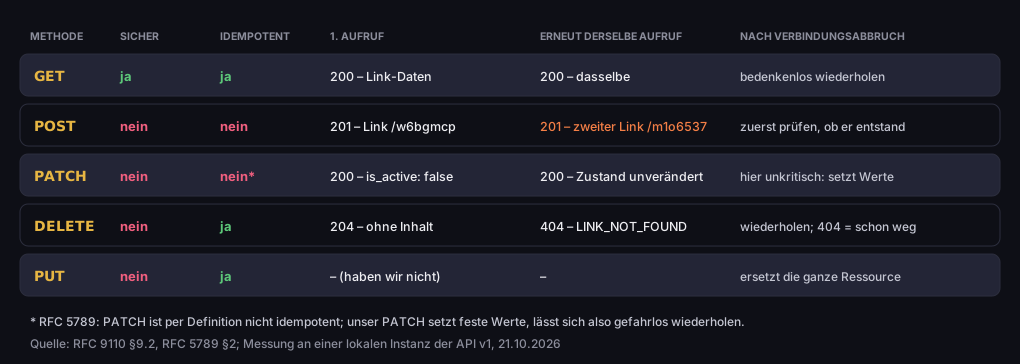
Welche Anfrage sich wiederholen lässt – HTTP-Methoden und unsere Messung
erster und zweiter identischer Aufruf an einer lokalen Instanz der API v1
Quelle: RFC 9110 §9.2, RFC 5789 §2; gemessen an einer lokalen Instanz der API v1, 21. Okt. 2026
Abbildungsbeschreibung
Tabelle. GET: sicher ja, idempotent ja; 200 mit Link-Daten, erneut 200 dasselbe; bedenkenlos wiederholen. POST: nein, nein; 201 und ein neuer Link, erneut 201 und ein zweiter, anderer Link; zuerst prüfen, ob er entstand. PATCH: nein, per Definition nicht; 200 is_active false, erneut 200 mit unverändertem Zustand; hier unkritisch, weil er Werte setzt. DELETE: nein, ja; 204 ohne Body, erneut 404 LINK_NOT_FOUND; wiederholen, 404 heißt schon weg. PUT: nein, ja; haben wir nicht.
Interessant ist DELETE. Der zweite Aufruf liefert einen anderen Code (404 statt 204), und trotzdem ist die Methode idempotent – denn Idempotenz betrifft die Wirkung auf den Server, nicht die Antwort. Nach einem Aufruf oder nach zweien ist der Link weg; ein Client, der DELETE nach einer abgerissenen Verbindung wiederholt und ein 404 erhält, kann die Aufgabe also als erledigt betrachten.
Bei POST ist es umgekehrt. Zwei identische Anfragen haben zwei verschiedene Links mit verschiedenen Adressen erzeugt. Reißt die Verbindung nach dem Senden eines POST ab, kann ein blindes Wiederholen ein Duplikat hinterlassen. Sicherer ist es, zuerst die Liste der Links abzurufen (GET /api/v1/links) und zu prüfen, ob es zu dieser URL schon einen Link gibt. Unser PATCH setzt Felder auf bestimmte Werte ("is_active": false), ein Wiederholen schadet also nicht – das ist aber eine Eigenschaft unserer Implementierung, nicht der Methode: Ein PATCH, der einer Liste ein Element anhängt, würde es zweimal anhängen.
Der Header Idempotency-Key versucht, das POST-Problem zu lösen: Der Client versieht die Anfrage mit einer eindeutigen Kennung, und ein Server, der sie ein zweites Mal sieht, führt die Operation nicht noch einmal aus. Der IETF-Entwurf beschreibt ihn als Mittel, nicht idempotente Methoden „wie POST oder PATCH“ fehlertolerant zu machen (draft-ietf-httpapi-idempotency-key-header-07, auf Englisch). Es ist aber ein Entwurf, der am 18. April 2026 abgelaufen ist, kein Standard. Unsere API unterstützt ihn nicht, die Regel „erst prüfen“ gilt also weiter.
REST-API-Statuscodes
Der Statuscode ist das Erste, was ein Programm prüfen sollte: Er sagt, ob der Aufruf funktioniert hat und, falls nicht, auf welcher Seite das Problem liegt. 2xx bedeutet Erfolg, 4xx einen Fehler in der Anfrage, 5xx einen Fehler auf dem Server. Diese begegnen Ihnen in unserer API:
|
Code |
Wann, in unserer API |
Was zu tun ist |
|---|---|---|
|
200 |
ein Lesen ( |
|
|
201 |
|
ihre |
|
204 |
|
nichts |
|
400 |
Validierungsfehler ( |
Anfrage korrigieren; nicht unverändert erneut senden |
|
401 |
kein Schlüssel, falsches Format, unbekannter, deaktivierter oder abgelaufener Schlüssel |
Schlüssel prüfen; Wiederholen hilft nicht |
|
403 |
dem Schlüssel fehlt die Berechtigung ( |
einen Schlüssel mit passendem Scope verwenden |
|
404 |
die Ressource existiert nicht, z. B. schon gelöscht ( |
die |
|
409 |
der gewählte Link-Slug ist vergeben ( |
einen anderen wählen |
|
429 |
Rate Limit überschritten |
|
Der Unterschied zwischen 401 und 403 wird oft verwechselt. 401 heißt „Ich weiß nicht, wer Sie sind“ – der Schlüssel fehlt oder ist ungültig. 403 heißt „Ich weiß, wer Sie sind, aber das dürfen Sie nicht“. In unserem Test erhielt ein Schlüssel, der nur den Scope links:read hatte, beim Versuch, einen Link anzulegen, 403 INSUFFICIENT_PERMISSIONS. Scopes und ihre Wahl für eine Integration behandelt der Leitfaden zu API-Schlüsseln.
Zwei Gruppen von Codes haben eigene Leitfäden. Weiterleitungen – 301, 302, 307 und 308 – behandelt der Beitrag 301 vs. 302; für APIs ist wichtig, dass ein 301 oder 302 aus einem POST ein GET machen kann. Die Codes 404 und 410, auch die Frage, wann welcher, behandelt der Beitrag HTTP 404.
Rate Limits und 429: richtig reagieren
Eine öffentliche API begrenzt die Zahl der Anfragen, damit ein Client die anderen nicht verdrängt. Für das Überschreiten gibt es einen eigenen Code: 429 Too Many Requests bedeutet, dass der Nutzer „zu viele Anfragen in einer bestimmten Zeit“ gesendet hat, und die Antwort kann einen Header Retry-After enthalten, der sagt, wie lange zu warten ist (RFC 6585, §4, auf Englisch). Retry-After ist entweder ein Datum oder eine Anzahl von Sekunden (RFC 9110, §10.2.3, auf Englisch).
Unsere API hat zwei Limits pro Konto: je Stunde und je Minute. Im Tarif Starter sind das 100 Anfragen pro Stunde und 50 pro Minute, in Pro 10.000 und 200, in Business 50.000 und 500. Alle Schlüssel eines Kontos teilen sich dasselbe Limit. Warum zwei? Ein reines Stundenlimit lässt einen Client die ganze Stunde in wenigen Sekunden verbrauchen; das Minutenlimit verteilt den Verkehr. Beide arbeiten mit einem gleitenden Fenster: Der Server betrachtet die letzte Minute und die letzte Stunde, nicht volle Uhrzeitstunden.
Wir haben es an einem frischen Starter-Konto getestet: 60 Anfragen GET /api/v1/links hintereinander, dann eine Pause, so lang, wie der Server es verlangte, dann weitere Anfragen bis zur nächsten Ablehnung.
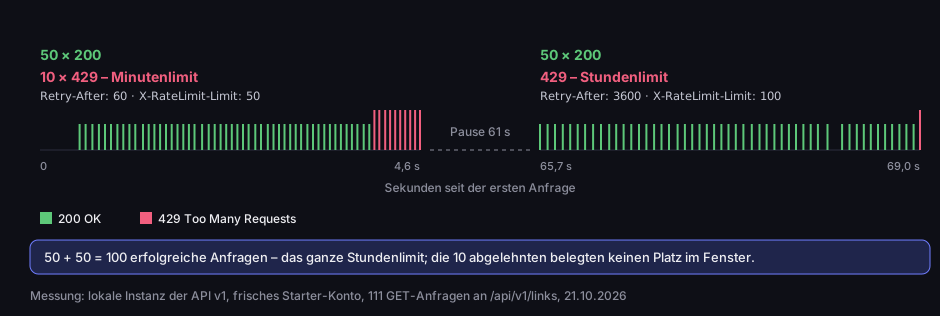
Rate Limits in der Praxis – Tarif Starter, 50 pro Minute und 100 pro Stunde
111 Anfragen GET /api/v1/links an einem frischen Konto, lokale Instanz
Gemessen: lokale Instanz der API v1, frisches Starter-Konto, 21. Okt. 2026
Abbildungsbeschreibung
Zeitleiste. Die ersten 50 Anfragen innerhalb von etwa 4 Sekunden: 200 OK. Die nächsten 10: 429, Minutenlimit, Header Retry-After: 60 und X-RateLimit-Limit: 50. Der Client wartet 61 Sekunden. Danach 50 Anfragen mit 200 OK und ein 429 am Stundenlimit, Retry-After: 3600, X-RateLimit-Limit: 100. Insgesamt 50 plus 50, also 100 erfolgreiche Anfragen – das ganze Stundenlimit; die 10 abgelehnten belegten keinen Platz im Fenster.
Die Messung zeigt drei praktische Dinge. Erstens sendet unsere API bei einem 429 Retry-After sowie die Header X-RateLimit-Limit, X-RateLimit-Remaining und X-RateLimit-Reset. Eine normale erfolgreiche Antwort trägt sie nicht – verlassen Sie sich also nicht darauf, um den Verbrauch laufend zu verfolgen. Zweitens nennt unser Retry-After die volle Länge des Fensters: 60 Sekunden beim Minutenlimit und 3.600 beim Stundenlimit. Das ist großzügig bemessen – in einem gleitenden Fenster kann ein Platz früher frei werden –, aber ein Client, der sich daran hält, landet immer in einem offenen Fenster.
Drittens: Eine abgelehnte Anfrage verbraucht das Limit nicht. Nach 50 erfolgreichen und 10 abgelehnten Anfragen reichte die Pause, damit weitere 50 durchkamen – insgesamt 100, das ganze Stundenlimit –, und die nächste Anfrage erhielt ein 429 mit Retry-After: 3600. Ein Wiederholen vor Ablauf von Retry-After kostet also nichts vom Limit, beschleunigt aber auch nichts: Es endet meist in einem weiteren 429 und erzeugt nur zusätzlichen Verkehr. Die richtige Reaktion auf ein 429 ist, Retry-After zu lesen, zu warten und erst dann die Anfrage erneut zu senden.
Paginierung: Seitenzahlen oder Cursor
Eine Liste von Ressourcen passt selten in eine Antwort, deshalb teilt eine API sie in Seiten. Es gibt zwei Ansätze, und unsere API nutzt beide, jeden dort, wo er passt.
Die Liste der Links arbeitet mit Seitenzahlen. Die Parameter page und limit (1 bis 100, Standard 20) stehen im Teil der URL hinter dem Fragezeichen, z. B. GET /api/v1/links?page=2&limit=50, und die Antwort enthält neben data ein Objekt pagination mit page, limit, total_pages, total_items und has_more. Ist has_more gleich false, sind Sie fertig. Das ist einfach und reicht aus, weil sich eine Liste von Links selten ändert.
Der Ereignisstrom – Klicks und Scans – wächst ständig, und Seitenzahlen würden ihn durcheinanderbringen. Ein Kommentar in unserem Code erklärt, warum: Beim Offset-Paging „verschiebt“ ein neues Ereignis zwischen zwei Seiten „alles nach unten“, und der Aufrufer liest stillschweigend eine Zeile doppelt oder überspringt eine. Deshalb werden Ereignisse mit einem Cursor durchgeblättert: Die Antwort liefert next_cursor, einen codierten Zeitstempel samt ID des letzten Ereignisses, und die nächste Anfrage verlangt alles danach. Das Ergebnis bleibt stabil, egal wie viele Ereignisse in der Zwischenzeit eintreffen.
Die Regel: Seitenzahlen für Sammlungen, die sich nicht verschieben; ein Cursor für Ströme, die ein Programm von Anfang bis Ende liest.
REST vs. SOAP vs. GraphQL
REST ist nicht der einzige Weg, eine API zu bauen, aber der verbreitetste. Die Postman-Umfrage 2025 zeigt, was Teams einsetzen – Mehrfachantworten waren möglich:
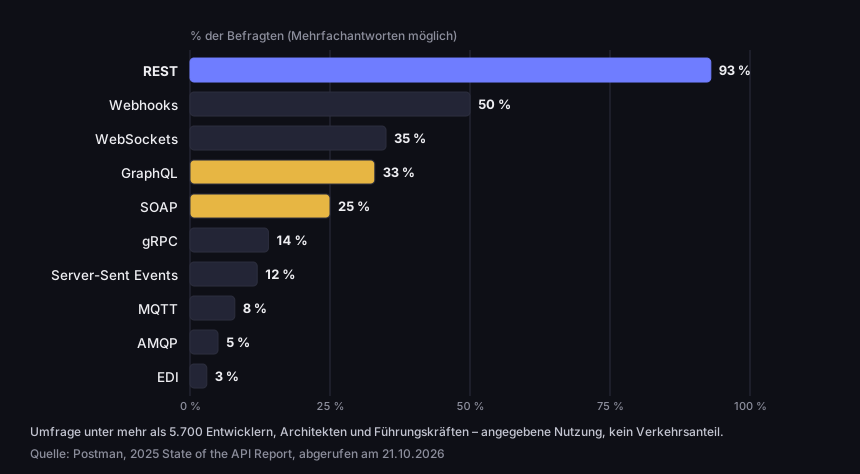
Welche API-Stile Teams nutzen (Postman 2025)
Anteil der Befragten, Mehrfachantworten möglich
Quelle: Postman, 2025 State of the API Report, abgerufen am 21. Okt. 2026
Abbildungsbeschreibung
Balkendiagramm. REST 93 %, Webhooks 50 %, WebSockets 35 %, GraphQL 33 %, SOAP 25 %, gRPC 14 %, Server-Sent Events 12 %, MQTT 8 %, AMQP 5 %, EDI 3 %. Eine Umfrage unter mehr als 5.700 Entwicklern, Architekten und Führungskräften; angegebene Nutzung, kein Anteil am Datenverkehr.
Die drei am häufigsten verglichenen Stile unterscheiden sich grundlegend:
|
Merkmal |
REST |
SOAP |
GraphQL |
|---|---|---|---|
|
Was es ist |
ein Architekturstil (Fielding, 2000) |
ein Nachrichtenprotokoll (W3C) |
eine Abfragesprache (GraphQL-Spezifikation) |
|
Nachricht |
eine Repräsentation einer Ressource, meist JSON |
ein XML-Umschlag ( |
Antwort meist als JSON |
|
Wer die Antwort formt |
der Server |
der Server, gemäß Vertrag |
der Client beschreibt die benötigten Daten |
|
Schnittstellenbeschreibung |
OpenAPI |
WSDL (eine XML-Sprache für Dienste) |
GraphQL-Schema |
Laut W3C ist SOAP „ein leichtgewichtiges Protokoll für den Austausch strukturierter Informationen in einer dezentralen, verteilten Umgebung“ (W3C, SOAP 1.2, auf Englisch). Es nutzt XML-Technologien: Jede Nachricht ist ein Umschlag (Envelope) mit optionalem Header und einem Body, und ein Dienst wird in WSDL beschrieben, einer XML-Sprache zur Beschreibung von Webdiensten (W3C, WSDL 2.0, auf Englisch). Es ist weiterhin im Einsatz – 25 % der Befragten in der Postman-Umfrage nutzen es.
GraphQL ist „eine Abfragesprache, die für den Bau von Client-Anwendungen entworfen wurde“, in der der Client die benötigten Daten beschreibt (GraphQL-Spezifikation, September 2025, auf Englisch). Bei REST bestimmt der Server die Form der Antwort, und Sie erhalten die ganze Ressource; bei GraphQL listen Sie genau die gewünschten Felder auf, auch aus mehreren verbundenen Objekten gleichzeitig. 33 % der Befragten nutzen es.
Manche Ratgeber behaupten, REST sei „X % schneller“ als SOAP – eine Messung dazu haben wir nicht gefunden. Die praktische Wahl ist einfacher: REST für eine öffentliche API, die viele Teams und Werkzeuge nutzen; SOAP, wenn das System, an das Sie sich anbinden, es verlangt; GraphQL, wenn ein Client viele Ressourcen flexibel kombinieren muss.
Für HTTP-APIs ist das Standardformat zur Beschreibung OpenAPI: eine Spezifikation, mit der Menschen und Programme die Fähigkeiten eines Dienstes entdecken können, „ohne Zugriff auf den Quellcode, zusätzliche Dokumentation oder die Untersuchung des Netzwerkverkehrs zu benötigen“ (OpenAPI Specification 3.1.0, auf Englisch). Unsere API hat eine solche Datei in Version 3.1.0, und die interaktive Dokumentation weiter unten wird daraus erzeugt.
Ihr erster Aufruf: die REST-API eines Link-Kürzers
Mit unserer API können Sie Kurzlinks anlegen, lesen, ändern und löschen sowie ihre QR-Codes und Statistiken abrufen. Sie steht ab dem Tarif Starter zur Verfügung und während des 7-tägigen Testzeitraums eines neuen Kontos; im Tarif Free lässt sich kein Schlüssel erstellen. Die Tarifdetails finden Sie auf der Preisseite.
Es sind drei Schritte. Zuerst registrieren Sie sich und klicken unter Einstellungen → API-Schlüssel auf „Schlüssel erstellen“. Der Server zeigt den Schlüssel nur ein einziges Mal. Dann senden Sie eine Anfrage mit dem Schlüssel im Header Authorization:
1curl -i -X POST https://dvnlinks.pl/api/v1/links \2 -H "Authorization: Bearer $DVN_API_KEY" \3 -H "Content-Type: application/json" \4 -d '{"original_url": "https://example.com/offer"}'Die Option -i zeigt Statuscode und Antwort-Header. Erwarten Sie 201 und ein data-Objekt mit dem Feld short_url. Zum Schluss lesen Sie den gerade angelegten Link über seine id:
1curl https://dvnlinks.pl/api/v1/links/LINK_ID \2 -H "Authorization: Bearer $DVN_API_KEY"Halten Sie den Schlüssel in einer Variablen und nicht im Befehl selbst, dann landet er nicht in Ihrer Shell-Historie. Der ältere Weg, den Schlüssel in der URL zu übergeben (?api_key=), funktioniert noch, wird aber abgeschafft: Solche Antworten tragen die Header Deprecation und Warning, weil eine URL mit Schlüssel in Logs landet. Warum das gefährlich ist und wie Sie einen Schlüssel aufbewahren, behandelt der Leitfaden zu API-Schlüsseln; die Schritt-für-Schritt-Anleitung steht in der Dokumentation zu API-Schlüsseln.
Jeder Endpunkt ist in der OpenAPI-3.1.0-Spezifikation und in der interaktiven Dokumentation unter /api/reference beschrieben, wo Sie Anfragen direkt aus dem Browser senden können. Dieselben Schritte im Dashboard, von der Registrierung bis zum ersten Link, stehen in Erste Schritte; in der Dokumentation gibt es außerdem eine Einführung in die API. Was die API nicht kann: Sie legt keine Bio-Seiten und keine QR-Codes an, die auf Dateien führen, und kennt keine Massenoperationen – jeder Link ist eine eigene Anfrage. Klick-Benachrichtigungen an Ihren Server gibt es als Webhooks ab dem Tarif Pro; eingerichtet werden sie in den Einstellungen des Dashboards, nicht über die API. Die vollständige Funktionsliste finden Sie auf der Funktionsseite.
Häufige Fragen
Ein Vertrag, über den ein Programm ein anderes nutzt: Welche Fragen es stellen darf und was zurückkommt. Im Web meist über HTTP.
Eine API, die nach REST-Prinzipien gebaut ist: Ressourcen haben eigene URLs, Operationen sind HTTP-Methoden, und der Server hält keinen Sitzungszustand. In der Praxis bedeuten „RESTful“ und „REST-API“ dasselbe – eine HTTP-API im REST-Stil –, obwohl nach Fieldings Definition keine von beiden ohne Hypermedia vollständig REST ist.
SOAP ist ein W3C-Protokoll mit XML-Umschlag und einem Vertrag in WSDL; REST ist ein auf HTTP aufbauender Stil, meist mit JSON. Wählen Sie SOAP, wenn das System, an das Sie sich anbinden, es verlangt.
Nein. Fielding spricht von Repräsentationen einer Ressource, und deren Format ist ein Medientyp: „Das Datenformat einer Repräsentation wird als Medientyp bezeichnet“ (Kap. 5, auf Englisch). JSON ist eine Konvention, keine Pflicht – dieselbe API könnte auch XML oder CSV liefern.
Dass Sie in einer bestimmten Zeit zu viele Anfragen gesendet haben. Lesen Sie den Header Retry-After und warten Sie so viele Sekunden; ein sofortiges Wiederholen endet meist in einem weiteren 429.
Möchten Sie eine REST-API an Ihrem eigenen Konto im Einsatz sehen? Registrieren Sie sich, erzeugen Sie einen Schlüssel und legen Sie mit einem einzigen curl-Befehl einen Link an – die API steht ab dem Tarif Starter und während des Testzeitraums zur Verfügung.