HTTP 404: Was der Fehler bedeutet und wie Sie ihn beheben
HTTP 404 Not Found heißt: Unter dieser Adresse liegt nichts. Was Besucher tun können, wie Seitenbetreiber den Fehler beheben und wie gedruckte Links und QR-Codes nicht ins Leere laufen.
HTTP 404 Not Found bedeutet: Der Server läuft und hat geantwortet, aber unter genau dieser Adresse keine Seite gefunden. Die Meldung sagt also nicht, dass das Internet kaputt ist oder mit Ihrem Handy etwas nicht stimmt. Sie sagt, dass der Link ins Leere führt: Jemand hat die Seite verschoben oder gelöscht, die Adresse enthält einen Tippfehler, oder die Aktion, auf die sie verwies, ist längst vorbei. Für Besucher ist der 404 eine Sackgasse, aus der man meist in Sekunden wieder herauskommt. Für Seitenbetreiber ist er ein Signal: Irgendwo da draußen – in den Suchergebnissen, in einer E-Mail, auf einem Flyer oder in einem QR-Code auf einer Verpackung – steht eine Adresse, die niemanden mehr irgendwohin bringt. Im Folgenden erklären wir, was der Code laut HTTP-Spezifikation bedeutet, wie Google damit umgeht, wann ein 410 oder eine Weiterleitung die bessere Antwort ist und was Sie mit einem toten Link tun, den Sie nicht mehr korrigieren können, weil er schon gedruckt ist.
HTTP 404 Not Found: Was der Fehlercode bedeutet
Ein 404 ist die Antwort des Servers auf eine Anfrage an eine Adresse, unter der nichts liegt. Die HTTP-Spezifikation definiert ihn so: Der Server habe „keine aktuelle Darstellung der Zielressource gefunden“ oder wolle nicht preisgeben, dass es eine gibt (RFC 9110, §15.5.5, auf Englisch, hier und im Folgenden sinngemäß wiedergegeben). Die zweite Hälfte ist Absicht: Ein Server, der verbergen will, dass es eine Seite gibt, die jemand nicht sehen darf, darf statt 403 auch 404 antworten (RFC 9110, §15.5.4).
Wichtiger ist, was ein 404 nicht sagt. Dieselbe Spezifikation hält fest, dass er nicht angibt, ob die fehlende Seite nur vorübergehend oder für immer weg ist. Weiß der Server, dass die Seite dauerhaft entfernt wurde, sollte er besser 410 Gone antworten (RFC 9110, §15.5.5). Der 404 ist in der Praxis also die Standardantwort: „Hier ist nichts, und ich weiß nicht, ob es wiederkommt.“
Die erste Ziffer verrät, auf wessen Seite das Problem liegt. 4xx-Codes sind Anfragefehler: Der Client hat etwas verlangt, das der Server nicht liefern kann. MDN, die Entwicklerdokumentation von Mozilla, nennt den HTTP-Statuscode 404 eine „Client-Fehlerantwort“ und ergänzt: Links, die zu einer 404-Seite führen, würden „oft als fehlerhafte oder tote Links bezeichnet“ (MDN, 404 Not Found, automatisch aus dem Englischen übersetzt). 5xx-Codes sind etwas anderes: ein Fehler auf dem Server, der die Anfrage gar nicht bearbeiten konnte. Beim 404 funktioniert der Server einwandfrei – er hat nur nichts anzuzeigen. Deshalb sieht eine 404-Seite meist aus wie der Rest der Website, mit Menü und Fußzeile, während ein 500 oft nur eine nackte Fehlermeldung zeigt. In einer API sagen dieselben Codeklassen einem Programm, was es als Nächstes tun soll – wie das in der Praxis aussieht, zeigt unser Leitfaden zur REST-API.
„404-Fehler“ ist eigentlich eine Kurzform. Für den Server ist es kein Fehlschlag, sondern eine ehrliche Antwort. Der Fehler ist der Link, der dorthin führt.
Woher 404-Fehler kommen
Seiten verschwinden aus banalen Gründen. Die häufigsten:
- eine geänderte Adresse ohne Weiterleitung – jemand ändert den Titel eines Artikels, das CMS ändert stillschweigend den Slug, und die alte Adresse in Google, in E-Mails und in Links anderer Seiten führt ins Leere;
- eine gelöschte Seite – ein ausgelaufenes Produkt, eine geschlossene Stellenanzeige, eine alte Meldung;
- ein Tippfehler in der Adresse – im Link einer E-Mail, in einem Social-Media-Beitrag oder auf einem Ausdruck; der letzte Fall ist am schwersten zu beheben;
- eine abgelaufene Aktion – die HTTP-Spezifikation nennt sie sogar als typisches Beispiel für etwas, das absichtlich verschwindet (RFC 9110, §15.5.11);
- ein Website-Umzug – neues CMS, neue Domain, neue URL-Struktur und Weiterleitungen, die fehlen oder nur einen Teil der Seiten abdecken.
Das Ausmaß ist größer, als man vermutet. Im Oktober 2023 prüfte das Pew Research Center Seiten aus einer Stichprobe des Common-Crawl-Archivs, die zwischen 2013 und 2023 erfasst worden waren. Ein Viertel davon war nicht mehr erreichbar: 38 % der Seiten aus 2013 und 8 % der Seiten aus 2023 (Pew Research Center, 2024, auf Englisch). Derselbe Bericht fand mindestens einen defekten Link auf 23 % der Nachrichtenseiten, 21 % der Regierungsseiten und 54 % der Wikipedia-Seiten, und zwar im Bereich der Einzelnachweise. Zwei Einschränkungen. Erstens ist das eine US-Studie und kein Querschnitt des gesamten Webs: Die Seiten aus den Jahren 2013 bis 2023 sind eine Zufallsstichprobe aus dem Common-Crawl-Archiv, die Regierungsseiten stammen von US-amerikanischen .gov-Domains, und mit Wikipedia ist die englischsprachige Ausgabe gemeint. Zweitens zählte Pew eine Seite nur dann als nicht erreichbar, wenn sie einen von neun Fehlercodes lieferte oder gar nicht antwortete. Seiten, die den Bot mit einem anderen Code abwiesen, galten nicht als nicht erreichbar – aus demselben Grund schlägt unser Link-Monitoring bei einem 403 keinen Alarm, mehr dazu weiter unten.
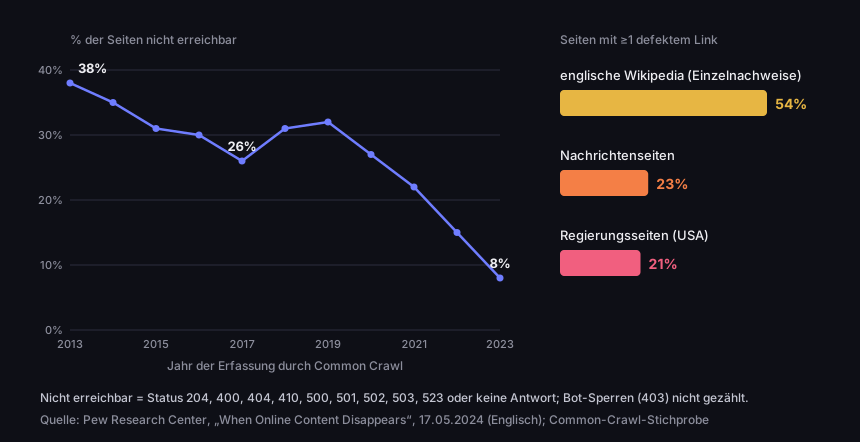
Wie viele Seiten verschwunden sind – Anteil nicht erreichbarer Seiten im Oktober 2023
nach dem Jahr der Erfassung durch Common Crawl, 2013–2023; daneben Seiten mit mindestens einem defekten Link
Quelle: Pew Research Center, „When Online Content Disappears“, 17. Mai 2024 (Englisch)
Abbildungsbeschreibung
Linien- und Balkendiagramm. Anteil der im Oktober 2023 nicht erreichbaren Seiten nach Erfassungsjahr: 2013 – 38 %, 2014 – 35 %, 2015 – 31 %, 2016 – 30 %, 2017 – 26 %, 2018 – 31 %, 2019 – 32 %, 2020 – 27 %, 2021 – 22 %, 2022 – 15 %, 2023 – 8 %. Balken: Seiten mit mindestens einem defekten Link – englische Wikipedia (Einzelnachweise) 54 %, Nachrichtenseiten 23 %, Regierungsseiten (USA) 21 %. Nicht erreichbar heißt Status 204, 400, 404, 410, 500, 501, 502, 503, 523 oder keine Antwort.
Noch deutlicher wird es dort, wo ein Link eine dauerhafte Quellenangabe sein sollte. In einer 2014 veröffentlichten Studie prüfte das Team um Jonathan Zittrain in Harvard die URLs, die in juristischen Fachzeitschriften und in Urteilen des Obersten Gerichtshofs der USA zitiert werden: Bei mehr als 70 % der URLs in den Zeitschriften und bei 50 % in den Urteilen führte der Link nicht mehr zu den ursprünglich zitierten Informationen (Harvard Law School, Zittrain, Albert, Lessig, auf Englisch). Das waren nicht nur 404-Antworten: Die Autoren zählten auch Links, die noch funktionierten, aber nicht mehr den zitierten oder nur noch veränderten Inhalt enthielten (Harvard Law Review Forum, 2014). Die Lehre bleibt dieselbe: Ein Link, um den sich niemand kümmert, funktioniert früher oder später nicht mehr.
Was Sie bei einem 404-Fehler tun können
Wenn Sie als Besucher auf einen 404 stoßen, liegt es mit hoher Wahrscheinlichkeit nicht an Ihnen, und Neuladen hilft nicht – der Server antwortet beim zweiten Mal genauso. Ein paar einfache Schritte helfen dagegen:
- Prüfen Sie die Adresszeile. Ein Tippfehler, ein beim Kopieren abgeschnittenes Ende, ein Punkt oder eine Klammer, die an einem Link aus einer Nachricht hängt – das sind häufige Ursachen. Woraus eine Adresse besteht und welcher Teil was bewirkt, erklären wir im Artikel Was ist eine URL? Aufbau, maximale Länge und URL vs. URI.
- Kürzen Sie die Adresse bis auf die Domain. Löschen Sie alles nach dem ersten Schrägstrich hinter dem Domainnamen und rufen Sie die Startseite auf. Von dort kommen Sie über das Menü oder die Suche meist an den Inhalt.
- Suchen Sie nach dem Seitentitel. Kennen Sie den Titel des Artikels oder den Produktnamen, suchen Sie ihn zusammen mit dem Namen der Website – vielleicht ist die Seite unter eine neue Adresse umgezogen.
- Probieren Sie ein Archiv. Webarchive wie die Wayback Machine bewahren Kopien mancher Seiten auf. Nicht jede Seite ist dort, und eine Kopie kann alt sein – das ist der letzte Ausweg, keine Garantie.
- Sagen Sie dem Inhaber Bescheid. Vor allem, wenn der Link von einem Flyer, einer Verpackung oder einem QR-Code stammt: Der Inhaber weiß oft gar nicht, dass sein Druck ins Leere führt.
QR-Codes sind ein Sonderfall. Lässt sich der Code gar nicht scannen – die Kamera erkennt ihn nicht, oder es passiert nichts –, liegt das Problem im Druck: Größe, Kontrast, Abstand. Das behandeln wir im Artikel QR-Code-Mindestgröße: warum ein Code nicht scannt und wie groß er sein muss. Lässt sich der Code scannen und öffnet eine 404-Seite, hat die Kamera ihre Arbeit getan – schiefgegangen ist die im Code gespeicherte Adresse oder die Seite, auf die sie zeigt. Erneutes Scannen oder ein anderes Handy ändern daran nichts.
Öffnet sich die Seite gar nicht – Zeitüberschreitung, Zertifikatsfehler, ein 502 oder 503 –, ist das etwas anderes als ein 404: Der Server ist ausgefallen oder nicht erreichbar. Wie Sie herausfinden, ob die Seite für alle nicht erreichbar ist oder nur für Sie, steht in unserem Leitfaden Website down? In 2 Minuten prüfen, ob es nur an Ihnen liegt.
404, 410 oder Soft 404: Was Google sieht
Für Google bedeuten 404 und 410 dasselbe: Der Inhalt ist nicht da. Die Google-Dokumentation zu HTTP-Statuscodes sagt: Alle 4xx-Fehler außer 429 werden gleich behandelt – die Crawler teilen dem nächsten Verarbeitungssystem mit, dass der Inhalt nicht vorhanden ist; eine zuvor indexierte URL wird aus dem Index entfernt, neue 404-Seiten werden nicht verarbeitet, und die Crawling-Frequenz nimmt allmählich ab (Google Search Central, HTTP-Statuscodes). Ausnahmen sind 429 und die 5xx-Codes: Für den Crawler heißen sie „Der Server ist überlastet oder fällt aus“, daher drosselt Google vorübergehend das Crawling, statt Seiten zu entfernen.
In SEO-Blogs liest man oft, ein 410 „entferne eine Seite schneller aus dem Index“ als ein 404. Die Google-Dokumentation sagt nichts dergleichen, und der Satz, dass alle 4xx-Codes gleich behandelt werden, spricht eher dagegen. Der Unterschied zwischen 404 und 410 liegt in der Bedeutung: 410 sagt, dass die Ressource absichtlich und wahrscheinlich für immer weg ist (RFC 9110, §15.5.11). Die Spezifikation fügt hinzu, dass man nicht alles Verschwundene als „gone“ markieren muss und dass ein Server, der nicht weiß, ob der Zustand dauerhaft ist, 404 antworten soll. MDN erläutert den 410 genau damit – einer abgelaufenen Aktion (MDN, 410 Gone).
Das eigentliche Problem ist der Soft 404. Das ist eine Seite, die wie ein Fehler aussieht, aber mit dem Status 200 – „alles in Ordnung“ – ausgeliefert wird. Die Search-Console-Hilfe beschreibt es so: Die Seite zeigt die nutzerfreundliche Meldung „Nicht gefunden“, aber keinen 404-HTTP-Antwortcode, und Google empfiehlt, für tatsächliche „Nicht gefunden“-Seiten einen 404-Antwortcode zurückzugeben (Search Console, Bericht zur Seitenindexierung). Ein Soft 404 wird auch gemeldet, wenn eine Seite leer ist oder nur eine Fehlermeldung enthält: Deutet der Inhalt auf einen Fehler hin, zeigt die Search Console einen Soft-404-Fehler an (Google Search Central).
Die zweite Quelle von Soft 404s ist weniger offensichtlich: viele alte Adressen auf die Startseite weiterzuleiten. In ihrem Leitfaden zum Website-Umzug rät Google davon ab, weil es Nutzer verwirren und „als soft 404-Fehler gewertet werden“ kann (Google Search Central, Website-Umzug). Derselbe Leitfaden verlangt, dass entfernte Seiten auf der neuen Website einen 404 oder 410 liefern.
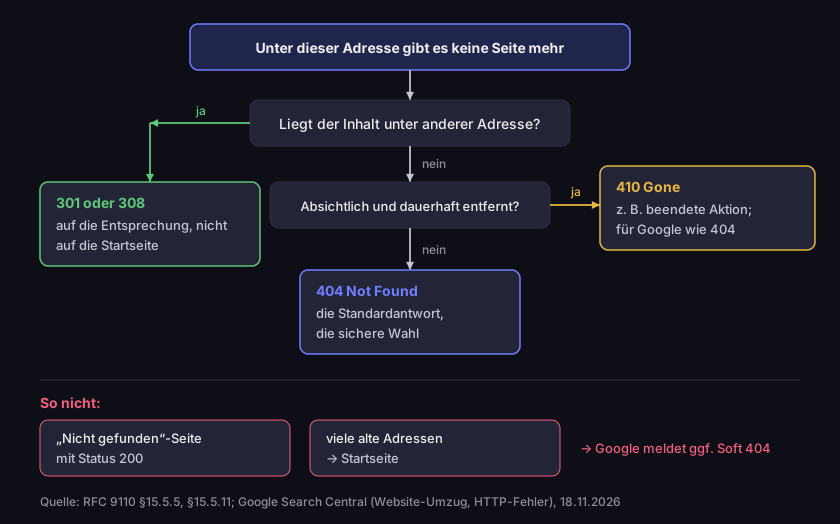
Die Seite ist weg – was der Server antworten soll
Entscheidungsbaum nach RFC 9110 und der Google-Dokumentation
Quelle: RFC 9110 §15.5.5 und §15.5.11; Google Search Central, abgerufen am 18.11.2026
Abbildungsbeschreibung
Entscheidungsbaum. Unter dieser Adresse gibt es keine Seite mehr. Liegt der Inhalt unter anderer Adresse? Ja: Weiterleitung 301 oder 308 auf die Entsprechung, nicht auf die Startseite. Nein: Wurde die Seite absichtlich und dauerhaft entfernt? Ja: 410 Gone, zum Beispiel bei einer beendeten Aktion; für Google wie ein 404. Nein oder unsicher: 404 Not Found, die Standardantwort und sichere Wahl. Darunter zwei Fehler: eine Nicht-gefunden-Seite mit Status 200 und viele alte Adressen, die auf die Startseite weiterleiten – Google kann beides als Soft 404 melden.
Schaden 404-Fehler dem Ranking? Google hat das schon 2011 beantwortet: 404-Fehler seien „ein ganz normaler Teil des Webs“ – das Internet verändere sich ständig, alte Inhalte würden gelöscht, und eine gelöschte Seite gebe idealerweise einen 404 zurück (Google Search Central Blog, 2011). Im selben Beitrag schreibt Google, es sei einem korrekten 404 oder 410 lieber als einem Soft 404. Der Schaden liegt also nicht im Code selbst, sondern in dem, was Sie verlieren: den Besuchern, die über Links zur verschwundenen Adresse kamen, und denen, die vor einer leeren Seite abgesprungen sind.
So beheben Sie einen 404-Fehler auf der eigenen Website
Am Anfang steht eine Frage: Was ist mit dem Inhalt passiert? Liegt er unter einer anderen Adresse, richten Sie eine dauerhafte Weiterleitung ein – 301 oder 308 – von der alten auf die neue. Die Search-Console-Hilfe sagt genau das: Ist Ihre Seite umgezogen, verwenden Sie eine 301-Weiterleitung zur neuen Ziel-URL; wurde sie ersatzlos entfernt, ist ein 404 kein Problem (Search Console). Leiten Sie auf die Entsprechung weiter, nicht auf die Startseite: einen Artikel auf die neue Adresse des Artikels, ein Produkt auf seinen Nachfolger oder seine Kategorie. Welchen Weiterleitungscode Sie wählen und wie Sie ihn auf einem Server einrichten, steht in unserem Artikel HTTP 302 oder 301: Weiterleitungscodes, Google und Caching.
Ist der Inhalt weg und hat keinen Nachfolger, lassen Sie den 404 stehen – oder antworten mit 410, wenn Sie wissen, dass das Entfernen gewollt und endgültig ist. Versuchen Sie nicht, solche Adressen mit einer Weiterleitung auf die Startseite zu „retten“: Der Besucher suchte etwas Bestimmtes, landet auf einer Seite ohne es, und Google kann das als Soft 404 werten.
Kümmern Sie sich um die Fehlerseite selbst. Eine gute 404-Seite tut drei Dinge: Sie liefert einen echten 404-Status (nicht 200), sagt in einfachen Worten, dass die Seite nicht da ist, und zeigt einen Weg weiter – Menü, Suchfeld, Links zu den wichtigsten Bereichen. In den meisten CMS stellen Sie sie im Theme ein; auf einem Apache-Server verweisen Sie in der Datei .htaccess darauf (MDN). Den Status prüfen Sie mit curl -I und der Adresse oder in den Entwicklertools des Browsers auf dem Tab „Netzwerk“.
Tote Adressen auf der eigenen Website finden Sie in der Google Search Console im Bericht „Seitenindexierung“: Unter „Nicht gefunden (404)“ stehen URLs, die der Crawler aufgerufen und mit 404 beantwortet bekommen hat, unter „Soft 404-Fehler“ Fehlerseiten mit Status 200. Derselbe Bericht zeigt auch Weiterleitungsfehler – zu lange Ketten und Schleifen (Search Console). Die Search Console weist außerdem darauf hin, dass es keine Möglichkeit gibt, den Googlebot anzuweisen, eine URL dauerhaft zu ignorieren – er ruft sie nur immer seltener auf. Ein paar alte 404 im Bericht sind kein Grund zur Sorge.
So sieht das bei uns aus. Wir haben gemessen, was unsere Adressen in vier Fällen antworten: eine Seite, die es nie gab, ein Artikel unter seiner alten Adresse, ein Kurzlink mit einem Code, den es nicht gibt, und die Seite für abgelaufene Links.
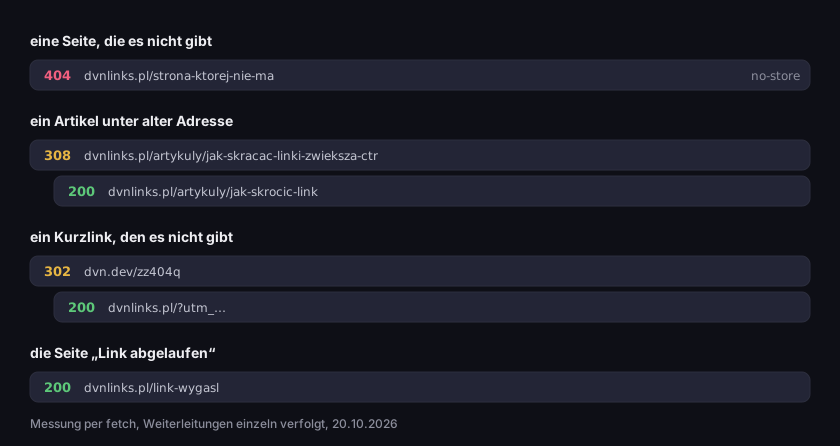
Keine Seite oder kein Link – was unsere eigenen Adressen antworten
jeder Schritt einzeln, HTTP-Status und Adresse
Quelle: Messung von DVN Links (fetch, Schritt für Schritt), 20.10.2026
Abbildungsbeschreibung
Vier Messungen. Eine Seite, die es nicht gibt, dvnlinks.pl/strona-ktorej-nie-ma: 404 mit dem Header no-store. Ein Artikel unter alter Adresse, dvnlinks.pl/artykuly/jak-skracac-linki-zwieksza-ctr: 308 auf die neue Adresse, danach 200. Ein Kurzlink, den es nicht gibt, dvn.dev/zz404q: eine 302-Weiterleitung auf die Startseite von dvnlinks.pl mit UTM-Parametern, danach 200. Die Seite „Link abgelaufen“: 200.
Die fehlende Seite bekommt einen echten 404, und der umbenannte Artikel eine einzige 308-Weiterleitung direkt auf die neue Adresse, ohne Kette. Kurzlinks verhalten sich anders, wie der nächste Abschnitt erklärt.
Tote Links im Druck und in QR-Codes
Ein Link in einer E-Mail lässt sich korrigieren und neu versenden. Ein Link auf einem Flyer, Plakat, einer Verpackung oder der QR-Code auf einer Visitenkarte nicht – der Druck ist längst draußen. Enthält der Code die vollständige Adresse einer Seite und verschwindet diese, endet jeder Scan in einem 404, bis Sie neu drucken. Eine typische Geschichte: Der Code auf einem Flyer führt zur Seite einer Sommeraktion, die Aktion endet, jemand räumt die Website auf und löscht die Seite, und die Flyer liegen immer noch an den Ladentheken.
Die Lösung ist eine Zwischenschicht: ein Kurzlink zwischen Druck und Zielseite. Der Code speichert die kurze Adresse, und der Kurzlink leitet auf die eigentliche Seite weiter. Verschwindet das Ziel, ändern Sie im Dashboard das Ziel des Kurzlinks, und der gedruckte Code führt woandershin. Bei DVN Links leitet ein Kurzlink mit 302 weiter, einer vorübergehenden Weiterleitung, damit sich Browser das alte Ziel nicht merken und die Änderung für jeden weiteren Scan gilt. Warum ein Kurzlink-Dienst 302 statt 301 antworten sollte, erklärt der Artikel Link kürzen, ohne die Klickstatistik zu verlieren.
Zwei Dinge sollten Sie darüber wissen, was unser Dienst tut, wenn ein Link ins Leere führt:
- Ein abgelaufener Link liefert keinen 404. Ab dem Tarif Starter können Sie einem Kurzlink ein Ablaufdatum geben. Wer ihn danach öffnet, wird mit 302 auf unsere Seite „Link abgelaufen“ weitergeleitet, die mit 200 antwortet und erklärt, was passiert ist. Ohne Datum hat ein Link in keinem Tarif ein Ablaufdatum.
- Auch ein Code, den es nicht gibt, liefert keinen 404. Tippt oder scannt jemand einen Code, der nicht existiert, antworten wir mit einer einzigen 302-Weiterleitung auf die Startseite der Website, versehen mit
utm_campaign=not_found– so sehen wir in unserer Analyse, wie viele solche Aufrufe es gibt und von welcher Domain sie kommen. Google sagt, dass die Weiterleitung vieler Adressen auf die Startseite als Soft 404 gewertet werden kann. Wir tun es bewusst: Eine Kurzadresse hat kein Suchranking, das verloren gehen könnte, und wer einen defekten Code gescannt hat, landet auf einer funktionierenden Seite statt vor einem leeren Fehler.
Bevor Sie etwas drucken, scannen Sie den Code von einem Probedruck mit Ihrem Handy und öffnen Sie die Seite bis zum Ende – prüfen Sie nicht nur, ob die Kamera den Code erkennt. Einen QR-Code erstellen Sie in unserem QR-Code-Generator; soll er über einen Kurzlink laufen, legen Sie zuerst den Link an und setzen dessen Adresse in den Code.
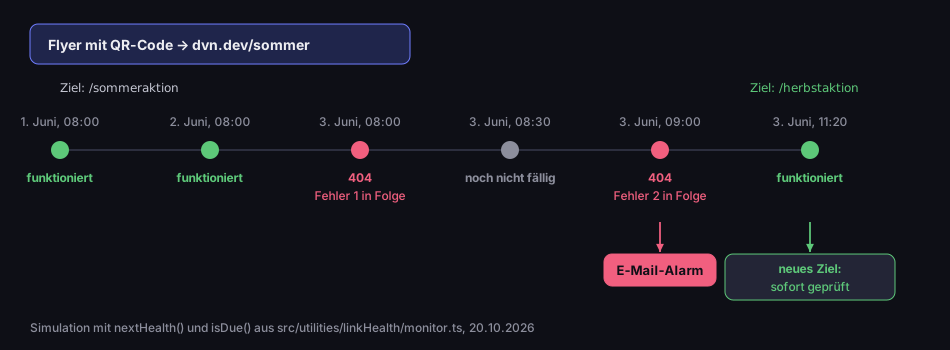
Ein gedruckter QR-Code, ein Ziel liefert 404 – was das Monitoring tut
Zeitachse aus der echten Monitoring-Logik von DVN Links
Quelle: Simulation mit den Monitoring-Funktionen von DVN Links (nextHealth, isDue), 20.10.2026
Abbildungsbeschreibung
Zeitachse. Ein Flyer mit QR-Code verweist auf den Kurzlink dvn.dev/sommer, der auf /sommeraktion zeigt. 1. Juni, 08:00 und 2. Juni, 08:00: tägliche Prüfung, die Seite funktioniert. 3. Juni, 08:00: Die Seite liefert 404, erster Fehler in Folge, kein Alarm. 08:30: noch nicht wieder an der Reihe. 09:00: 404, zweiter Fehler in Folge – E-Mail-Alarm. 11:20: Der Inhaber ändert das Ziel auf /herbstaktion; die neue Adresse wird sofort geprüft und funktioniert; der gedruckte Code führt auf die neue Seite.
Wie ein Bot prüft, ob ein Link lebt (und warum nicht nach einem einzigen Fehler)
Das Ziel zu ändern hilft nur, wenn Sie wissen, dass es geändert werden muss. Deshalb hat DVN Links ab dem Tarif Pro eine Link-Überwachung: Einmal täglich prüft sie das Ziel jedes aktiven Kurzlinks und schickt Ihnen eine E-Mail, sobald die Seite nicht mehr funktioniert. Business und Enterprise ergänzen einen Wochenbericht. Die Tarife Free und Starter enthalten keine Überwachung – Einzelheiten auf der Preisseite, eine Beschreibung auf der Funktionsseite. Eine Einschränkung: Die Überwachung beobachtet die Ziele Ihrer Kurzlinks, nicht die Links auf Ihrer Website – sie ist kein Broken-Link-Checker, der Ihre Seite durchkämmt. Sie prüft außerdem nur das Standardziel eines Links, nicht die Ziele von Regeln oder A/B-Varianten, und überspringt Links auf Dateien, die wir selbst hosten.
Beim Bau mussten ein paar Fragen geklärt werden, die jeder Link-Checker beantworten muss:
- Erst HEAD, bei Ablehnung GET. Der Monitor fragt zuerst mit der Methode HEAD – nur Header, ohne die Seite herunterzuladen. Manche Server behandeln HEAD anders als einen normalen Besuch, daher fragen wir bei 403, 405 oder 501 noch einmal mit GET.
- Weiterleitungen Schritt für Schritt, höchstens fünf. Jeder Schritt wird einzeln geprüft, auch darauf, ob er in ein privates Netzwerk führt. Eine sechste Weiterleitung in Folge zählt als „zu viele Weiterleitungen“. Das Limit von fünf geht auf eine frühere Fassung der HTTP-Spezifikation zurück, die es empfahl; die aktuelle erinnert Entwickler daran, dass manche Clients ein solches festes Limit womöglich noch haben (RFC 9110, §15.4).
- 401, 403 und 429 sind keine tote Seite. Viele Websites halten Bots fern: Sie verlangen eine Anmeldung, weisen unbekannte Software ab oder begrenzen Anfragen. Eine solche Antwort sagt etwas über den Bot, nicht über die Seite – ein Mensch im Browser sähe sie problemlos. Wir markieren sie als „Ziel konnte nicht geprüft werden“ und schicken keinen Alarm. Das Pew Research Center ging ebenso sorgfältig vor: Es zählte eine Seite nur bei neun Fehlercodes als nicht erreichbar, weil viele Websites automatisierte Datenerhebung aktiv verhindern (Pew Research Center).
- Als defekt gelten 404, 410, andere 4xx- und 5xx-Fehler, eine nicht existierende Domain, ein ungültiges Zertifikat, eine verweigerte Verbindung oder keine Antwort innerhalb von 10 Sekunden. Steht die Zieladresse auf der Liste von Google Safe Browsing, markiert die Überwachung sie als unsicher – was diese Liste erfasst, steht in Link überprüfen: Ist er sicher? So prüfen Sie vor dem Klick.
Wir haben das an der echten Überwachungsfunktion getestet und sie auf einen Testserver gerichtet, der auf dreizehn verschiedene Arten antwortete.
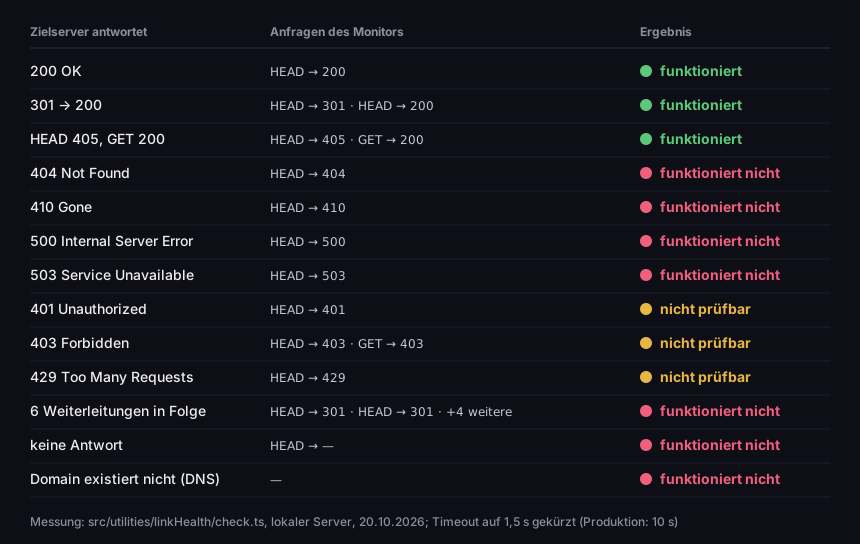
Wie die Link-Überwachung die Antwort eines Ziels bewertet
13 Antwortvarianten, die Anfragen des Monitors und das Ergebnis
Quelle: Messung von DVN Links – die Prüffunktion der Überwachung gegen einen lokalen Testserver, 20.10.2026
Abbildungsbeschreibung
Tabelle mit dreizehn Varianten. 200 OK: eine HEAD-Anfrage, funktioniert. 301 auf eine Seite mit 200: zwei HEAD-Anfragen, funktioniert. HEAD 405, GET 200: erst HEAD, dann GET, funktioniert. 404, 410, 500 und 503: eine HEAD-Anfrage, funktioniert nicht. 401 und 429: eine HEAD-Anfrage, nicht prüfbar. 403: HEAD und GET, nicht prüfbar. Sechs Weiterleitungen in Folge: sechs HEAD-Anfragen, funktioniert nicht (zu viele Weiterleitungen). Keine Antwort: funktioniert nicht (Zeitüberschreitung). Domain existiert nicht: keine HTTP-Anfrage, funktioniert nicht.
Zuletzt ging es um die Frage, wann Alarm geschlagen wird. Eine einzige fehlgeschlagene Prüfung reicht nicht: Der Server wurde vielleicht gerade neu gestartet, oder das Netz hatte einen Aussetzer. Fällt eine Seite durch, prüft der Monitor sie deshalb eine Stunde später erneut und schickt erst nach dem zweiten Fehler in Folge eine E-Mail. Die Ausnahme ist der Zustand „unsicher“ – den melden wir sofort. Ändern Sie das Ziel eines Links, wartet die neue Adresse nicht auf den täglichen Termin: Sie kommt sofort in die Warteschlange, die Überwachung läuft alle fünf Minuten, und ihr Verlauf beginnt bei null. Wir senden höchstens eine E-Mail pro Tag, die alle Links mit Problem bündelt, und nach einer Korrektur eine E-Mail, dass die Seite wieder funktioniert. Im Dashboard zeigt jeder Link einen Statuspunkt: „Ziel funktioniert“, „Ziel konnte nicht geprüft werden“, „Ziel funktioniert nicht“ oder „Ziel als unsicher markiert“.
Häufig gestellte Fragen
Dass der Server läuft, aber unter dieser Adresse keine Seite gefunden hat. Der Code sagt nicht, ob das Fehlen vorübergehend oder dauerhaft ist, und er bedeutet nicht, dass der Server ausgefallen ist – es ist die Antwort auf eine Anfrage an eine Adresse, die es nicht gibt (RFC 9110, auf Englisch).
Nicht von selbst. Google nennt 404-Fehler einen normalen Teil des Webs und entfernt solche URLs aus dem Index (Google Search Central Blog). Verloren geht der Verkehr über Links, die auf die verschwundene Adresse zeigten – liegt der Inhalt jetzt woanders, richten Sie eine 301-Weiterleitung ein.
Dasselbe wie am Computer: die Adresse prüfen, bis auf die Domain kürzen, nach der Seite suchen. Stammt die Adresse aus einem QR-Code, hat Ihr Handy ihn richtig gelesen – der Fehler steckt in der Adresse oder auf der Website. Am besten sagen Sie dem Inhaber des Codes Bescheid.
410, wenn Sie wissen, dass die Seite absichtlich und endgültig weg ist, zum Beispiel nach dem Ende einer Aktion. Im Zweifel 404. Für Google funktionieren beide Codes gleich (Google Search Central).
Auf der eigenen Website in der Google Search Console im Bericht „Seitenindexierung“ unter „Nicht gefunden (404)“. Für Kurzlinks und QR-Codes, die Sie geteilt oder gedruckt haben, beobachtet die Link-Überwachung von DVN Links sie ab dem Tarif Pro – siehe Preise.
Sie drucken einen QR-Code? Geben Sie ihm einen Kurzlink mit Überwachung – dann erfahren Sie von einem 404, bevor ein Kunde ihn meldet. Die Tarife mit Überwachung finden Sie auf der Preisseite, ein Konto erstellen Sie hier.