API REST : comment ça marche, avec un exemple réel
Ce qu’est une API REST, des six contraintes de Fielding aux méthodes, codes d’état, limites de débit et pagination, montré sur une API en production avec de vraies réponses.
Une API REST est le moyen par lequel un programme parle à un autre via HTTP, le protocole que votre navigateur utilise pour charger les pages web. L’URL désigne une ressource, par exemple un lien dans un raccourcisseur d’URL ; la méthode HTTP dit quoi en faire (GET lit, POST crée, DELETE supprime) ; et le serveur répond par un code d’état et des données, le plus souvent en JSON. REST n’est ni un protocole ni une bibliothèque : c’est un style d’architecture décrit par Roy Fielding dans sa thèse de doctorat, en 2000. Ce guide part de la source, avec les six contraintes de Fielding et la raison pour laquelle, selon leur auteur, la plupart des « API REST » n’en sont pas. Il passe ensuite à la pratique, sur l’API en production du service de liens courts DVN Links : de vraies requêtes et réponses, les requêtes qu’on peut rejouer sans risque, ce que signifient 401, 403 et 429, et le comportement d’une limite de débit, mesuré requête par requête.
Qu’est-ce qu’une API, et qu’est-ce qui en fait une API REST ?
Une API (interface de programmation d’application) est un contrat entre programmes : quelles questions l’un peut poser à l’autre, comment les formuler et ce qui revient. Une interface utilisateur est faite pour les personnes, avec des boutons et des formulaires. Une API est faite pour les logiciels. Quand une boutique en ligne récupère l’état d’un colis auprès d’un transporteur, ou qu’un outil d’e-mailing crée un lien court pour chaque newsletter, tout passe par l’API du fournisseur, sans que personne ne clique dans un tableau de bord.
Sur le web, les API passent généralement par HTTP, et c’est là qu’intervient le mot REST. MDN, la référence tenue par Mozilla, décrit la situation honnêtement : les API HTTP simples sont parfois appelées familièrement API RESTful « même s’ils n’adhèrent pas nécessairement à toutes les contraintes REST », et les débutants peuvent supposer qu’une API REST est un service HTTP que l’on appelle avec des bibliothèques et des outils web standards (MDN, REST, version française). C’est une bonne définition de travail. « RESTful » veut dire la même chose en pratique : une API conçue selon les principes REST, dans la mesure où le reste de la profession les applique.
Dans l’enquête 2025 de Postman auprès de plus de 5 700 développeurs, architectes et dirigeants, 93 % des répondants utilisent REST (Postman, 2025 State of the API Report, en anglais). Ce sont des déclarations d’usage, pas une part du trafic : une même équipe peut employer plusieurs styles à la fois.
Les contraintes d’une API REST : les six règles de Fielding
REST est un ensemble de contraintes que Fielding impose à l’architecture d’un système en réseau. Son idée centrale est la ressource : « L’abstraction clé de l’information dans REST est une ressource », c’est-à-dire tout ce qui peut être nommé, d’un document à une image (R. Fielding, thèse, chap. 5, en anglais ; les citations de sources anglaises sont ici en traduction libre). Dans l’API d’un raccourcisseur de liens, la ressource est un lien, et son nom est l’adresse /api/v1/links/{id}. Il y a six contraintes, et chacune peut être vérifiée sur une API réelle :
- Client-serveur. L’interface sépare le client du stockage des données, si bien que les deux côtés peuvent évoluer indépendamment. Fielding souligne que cette séparation permet aux composants d’« évoluer indépendamment ». Nos intégrations ne savent rien du tableau de bord ni de la base de données : elles voient des URL et du JSON.
- Sans état. Chaque requête doit contenir tout ce dont le serveur a besoin pour la comprendre, et ne peut « tirer parti d’aucun contexte stocké sur le serveur » ; l’état de session reste chez le client. C’est pourquoi notre API n’a ni connexion ni session : la clé voyage avec chaque requête.
- Cache. Les données d’une réponse doivent être marquées comme réutilisables ou non. Notre spécification OpenAPI est servie avec
Cache-Control: public, max-age=3600, mais les réponses contenant des données de liens n’ont aucun marquage : cette contrainte n’est donc respectée qu’en partie. - Interface uniforme. Pour Fielding, c’est ce qui distingue le plus nettement REST des autres styles. Elle comprend quatre contraintes : l’identification des ressources, la manipulation des ressources par des représentations, des messages autodescriptifs et « l’hypermédia comme moteur de l’état de l’application », HATEOAS en abrégé.
- Système en couches. Un composant ne voit pas au-delà de la couche avec laquelle il communique directement. Les réponses de dvnlinks.pl portent l’en-tête
server: cloudflare: un CDN se trouve entre le client et notre serveur, et le client n’a pas besoin de le savoir. - Code à la demande. Le serveur peut étendre le client en lui envoyant du code à exécuter. Fielding parle d’« une contrainte facultative », la seule. Nous ne l’utilisons pas.
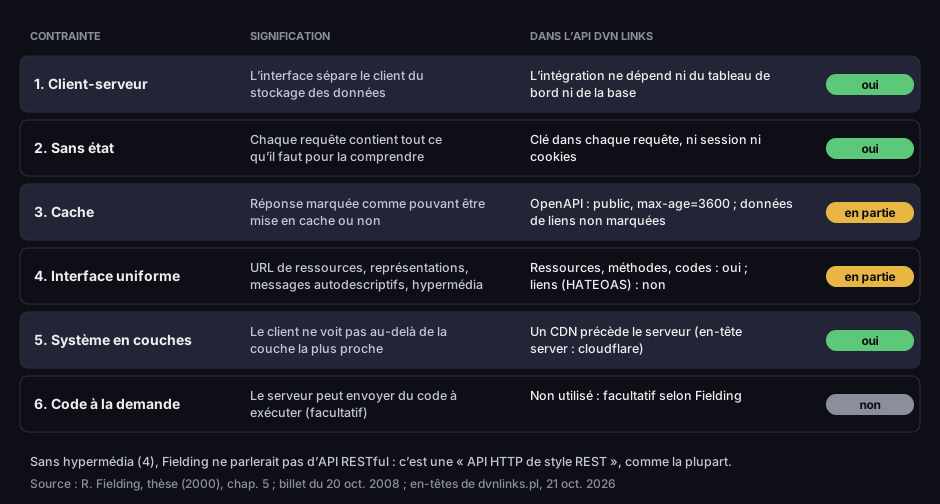
Les six contraintes REST de Fielding, et ce qu’en fait notre API
ce que signifie chaque contrainte et si l’API DVN Links la respecte
Source : R. Fielding, thèse (2000), chap. 5 ; billet du 20 oct. 2008 ; en-têtes de dvnlinks.pl, 21 oct. 2026
Description de la figure
Tableau de six contraintes. Client-serveur : l’interface sépare le client des données ; chez nous oui. Sans état : chaque requête contient tout le nécessaire ; chez nous oui, la clé dans chaque requête. Cache : une réponse est marquée comme pouvant être mise en cache ou non ; chez nous en partie, la spécification OpenAPI avec public, max-age=3600, données de liens non marquées. Interface uniforme : ressources, représentations, messages autodescriptifs, hypermédia ; chez nous en partie, pas de HATEOAS. Système en couches : chez nous oui, un CDN en amont, en-tête server : cloudflare. Code à la demande : facultatif, chez nous non.
La quatrième contrainte est celle où presque toutes les « API REST » échouent. HATEOAS signifie que la réponse d’un serveur contient des liens vers les prochaines étapes possibles, et que le client les suit comme une personne suit les liens d’une page web, au lieu de connaître les URL par la documentation. Fielding a consacré un billet à ce sujet en 2008. Il commence par « Je suis exaspéré par le nombre de gens qui appellent API REST n’importe quelle interface basée sur HTTP » et conclut que si le moteur de l’état de l’application n’est pas piloté par l’hypertexte, « alors elle ne peut pas être RESTful et ne peut pas être une API REST » (R. Fielding, 20 octobre 2008, en anglais).
Notre API ne remplit pas cette condition : une réponse contenant un lien n’indique pas où le modifier ou le supprimer, car le programme connaît ces URL pour avoir lu la documentation. Au sens strict de Fielding, c’est une « API HTTP de style REST », comme la plupart des interfaces qui portent ce nom. Cela ne gêne pas une intégration, mais explique le débat récurrent « est-ce vraiment du REST ? ».
Anatomie d’une requête et d’une réponse
Chaque appel à une API REST est une paire de messages HTTP : une requête et une réponse. Une requête comprend quatre parties :
- la méthode : ce qu’il faut faire (
GET,POST,PATCH,DELETE) ; - l’URL de la ressource : sur quoi le faire (
/api/v1/linksest la collection de liens,/api/v1/links/{id}un lien précis) ; la construction d’une URL, y compris les paramètres après le point d’interrogation, est expliquée dans notre guide Qu’est-ce qu’une URL ; - les en-têtes : des informations sur la requête, comme qui demande (
Authorization) et le format du corps (Content-Type: application/json) ; - le corps : les données à enregistrer, le plus souvent vide en lecture.
Une réponse comprend un code d’état (trois chiffres), des en-têtes et un corps. Voici à quoi ressemble la création d’un lien court dans notre API, requête et réponse enregistrées sur une instance locale du même code que celui qui tourne en production :
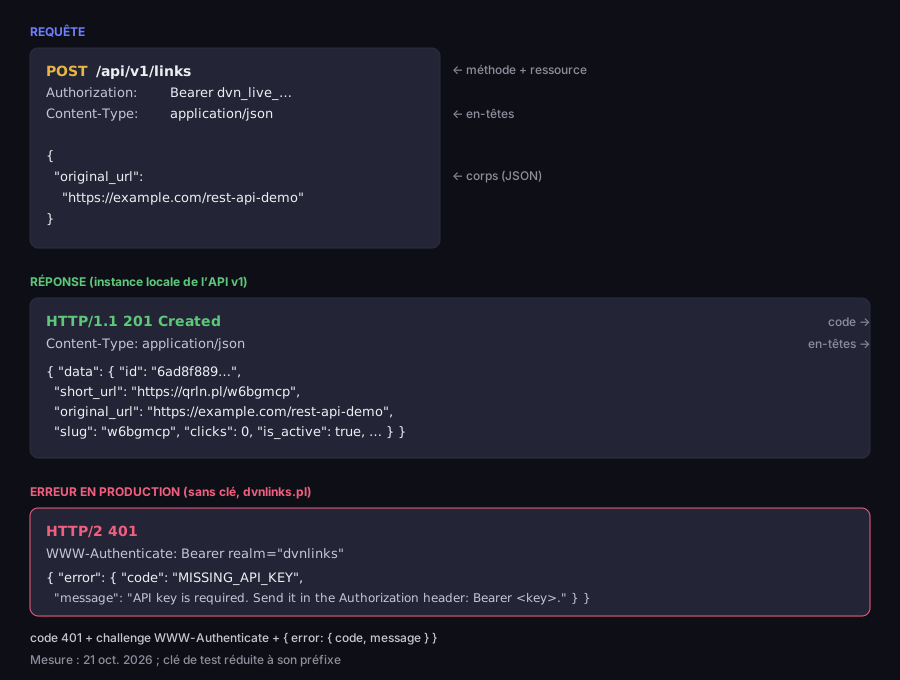
Anatomie d’un appel d’API REST : requête, réponse, erreur
POST /api/v1/links sur une instance locale ; un 401 de la production, sans clé
Mesuré : instance locale de l’API v1 et dvnlinks.pl, 21 oct. 2026 ; clé de test réduite à son préfixe
Description de la figure
Requête POST /api/v1/links avec les en-têtes Authorization: Bearer dvn*live*… et Content-Type: application/json et le corps {"original_url": "https://example.com/rest-api-demo"}. Réponse HTTP 201 Created, Content-Type: application/json, un corps data avec id, short_url sur le domaine qrln.pl, original_url, slug, clicks 0 et is_active true. En dessous, la réponse de la production de dvnlinks.pl sans clé: HTTP 401, en-tête WWW-Authenticate: Bearer realm="dvnlinks", un corps error avec le code MISSING_API_KEY et un message sur l’en-tête Authorization.
Deux choses dans cette figure valent pour n’importe quelle API. D’abord, les réponses ont une forme fixe : les données sont toujours dans un objet data, une erreur toujours dans error avec code et message. Un programme vérifie le code d’état, puis error.code, un identifiant stable, contrairement au message écrit pour les humains. Une erreur de validation ajoute details.field. L’envoi de {"original_url": "not-a-url"} renvoie 400 VALIDATION_ERROR avec "field": "original_url".
Ensuite, un 401 est plus qu’un nombre. La spécification HTTP dit qu’un serveur qui envoie un 401 « DOIT » envoyer un champ d’en-tête WWW-Authenticate avec au moins un challenge, c’est-à-dire une description de la manière de s’authentifier (RFC 9110, §15.5.2, en anglais). Notre API renvoie WWW-Authenticate: Bearer realm="dvnlinks" et ajoute error="invalid_token" lorsqu’une clé est rejetée, qu’elle soit mal formée, inconnue, désactivée ou expirée. Nous l’avons vérifié en production le 21 octobre 2026, sans clé et avec une clé mal formée.
Méthodes HTTP : quelles requêtes peut-on rejouer
Les méthodes HTTP ne diffèrent pas seulement par ce qu’elles font, mais aussi par le fait qu’on puisse ou non envoyer une requête deux fois. Cela compte quand la connexion tombe avant que le client lise la réponse : on ne sait pas si le serveur a eu le temps de faire quoi que ce soit.
La spécification HTTP définit deux propriétés. Une méthode sûre est une méthode dont la sémantique est « essentiellement en lecture seule » : le client n’attend aucun changement sur le serveur ; GET en est une (RFC 9110, §9.2.1, en anglais). Une méthode idempotente est une méthode pour laquelle plusieurs requêtes identiques ont le même effet qu’une seule. La RFC cite PUT, DELETE et les méthodes sûres, et explique l’intérêt de la distinction : une telle requête « peut être répétée automatiquement si une panne de communication survient avant que le client puisse lire la réponse du serveur » (RFC 9110, §9.2.2, en anglais).
Certains guides affirment que « PUT et PATCH sont idempotents ». La spécification de PATCH dit autre chose : « PATCH n’est ni sûre ni idempotente », même si une requête PATCH peut être écrite de façon à l’être (RFC 5789, §2, en anglais). Nous avons envoyé chaque requête deux fois de suite à une instance locale de notre API :
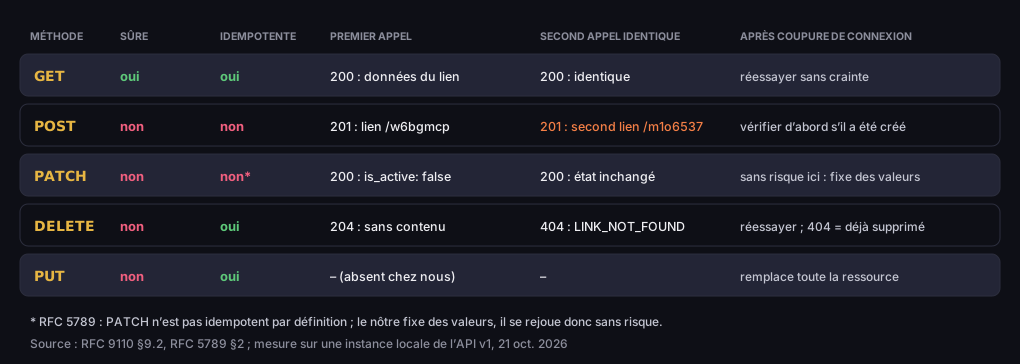
Quelle requête peut être rejouée : méthodes HTTP et notre mesure
premier et second appel identiques sur une instance locale de l’API v1
Source : RFC 9110 §9.2, RFC 5789 §2 ; mesuré sur une instance locale de l’API v1, 21 oct. 2026
Description de la figure
Tableau. GET : sûre oui, idempotente oui ; 200 avec les données du lien, de nouveau 200 identique ; réessayer sans crainte. POST : non, non ; 201 et un nouveau lien, de nouveau 201 et un second lien différent ; vérifier d’abord s’il a été créé. PATCH : non, pas par définition ; 200 is_active false, de nouveau 200 avec l’état inchangé ; sans risque ici car il fixe des valeurs. DELETE : non, oui ; 204 sans corps, de nouveau 404 LINK_NOT_FOUND ; réessayer, 404 signifie déjà supprimé. PUT : non, oui ; nous n’en avons pas.
DELETE est le cas intéressant. Le second appel renvoie un autre code (404 au lieu de 204), et pourtant la méthode est idempotente, car l’idempotence concerne l’effet sur le serveur, pas la réponse. Après un appel ou deux, le lien a disparu : un client qui rejoue DELETE après une coupure et obtient un 404 peut donc considérer la tâche comme faite.
POST, c’est l’inverse. Deux requêtes identiques ont créé deux liens différents, avec des adresses différentes. Si la connexion tombe après l’envoi d’un POST, un nouvel envoi à l’aveugle peut laisser un doublon. Il est plus sûr de récupérer d’abord la liste des liens (GET /api/v1/links) et de vérifier qu’aucun lien vers cette URL n’existe déjà. Notre PATCH fixe des champs à des valeurs précises ("is_active": false), le répéter ne fait donc aucun mal, mais c’est une propriété de notre implémentation, pas de la méthode : un PATCH qui ajoute un élément à une liste l’ajouterait deux fois.
L’en-tête Idempotency-Key tente de résoudre le problème de POST : le client donne à la requête un identifiant unique, et un serveur qui le voit une seconde fois ne répète pas l’opération. Le brouillon de l’IETF le décrit comme un moyen de rendre tolérantes aux pannes les méthodes non idempotentes « comme POST ou PATCH » (draft-ietf-httpapi-idempotency-key-header-07, en anglais). Mais c’est un brouillon expiré le 18 avril 2026, pas une norme. Notre API ne le prend pas en charge, la règle « vérifier d’abord » reste donc valable.
Codes d’état d’une API REST
Le code d’état est la première chose qu’un programme doit vérifier : il dit si l’appel a fonctionné et, sinon, de quel côté se situe le problème. 2xx signifie le succès, 4xx une erreur dans la requête, 5xx une erreur côté serveur. Voici ceux que vous rencontrerez dans notre API :
|
Code |
Quand, dans notre API |
Que faire |
|---|---|---|
|
200 |
une lecture ( |
lire |
|
201 |
|
conserver son |
|
204 |
|
rien |
|
400 |
erreur de validation ( |
corriger la requête ; ne pas la renvoyer telle quelle |
|
401 |
pas de clé, mauvais format, clé inconnue, désactivée ou expirée |
vérifier la clé ; réessayer ne servira à rien |
|
403 |
la clé n’a pas la permission ( |
utiliser une clé avec le bon scope |
|
404 |
la ressource n’existe pas, par exemple déjà supprimée ( |
vérifier l’ |
|
409 |
le slug de lien choisi est déjà pris ( |
en choisir un autre |
|
429 |
limite de débit dépassée |
attendre |
La différence entre 401 et 403 est souvent confondue. 401 signifie « je ne sais pas qui vous êtes » : la clé est absente ou invalide. 403 signifie « je sais qui vous êtes, mais vous n’en avez pas le droit ». Lors de notre test, une clé n’ayant que le scope links:read a reçu 403 INSUFFICIENT_PERMISSIONS en tentant de créer un lien. Les scopes, et la façon de les choisir pour une intégration, sont traités dans le guide sur les clés API.
Deux groupes de codes ont leurs propres guides. Les redirections (301, 302, 307 et 308) sont traitées dans Redirection 301 ou 302 ; pour les API, il faut retenir qu’un 301 ou un 302 peut transformer un POST en GET. Les codes 404 et 410, y compris le choix de l’un ou de l’autre, sont traités dans Erreur 404.
Limites de débit et 429 : bien réagir
Une API publique plafonne le nombre de requêtes pour qu’un client n’évince pas les autres. Un code existe pour le dépassement : 429 Too Many Requests signifie que l’utilisateur a envoyé « trop de requêtes dans un laps de temps donné », et la réponse peut contenir un en-tête Retry-After indiquant combien de temps attendre (RFC 6585, §4, en anglais). Retry-After est soit une date, soit un nombre de secondes (RFC 9110, §10.2.3, en anglais).
Notre API a deux limites par compte : une par heure et une par minute. Avec l’offre Starter, cela fait 100 requêtes par heure et 50 par minute ; avec Pro, 10 000 et 200 ; avec Business, 50 000 et 500. Toutes les clés d’un compte partagent la même limite. Pourquoi deux ? Une limite horaire seule permet à un client de consommer toute l’heure en quelques secondes ; la limite par minute étale le trafic. Toutes deux utilisent une fenêtre glissante : le serveur regarde la dernière minute et la dernière heure, pas les heures de l’horloge.
Nous l’avons testé sur un compte Starter neuf : 60 requêtes GET /api/v1/links à la suite, puis une attente aussi longue que le serveur le demandait, puis de nouvelles requêtes jusqu’au refus suivant.
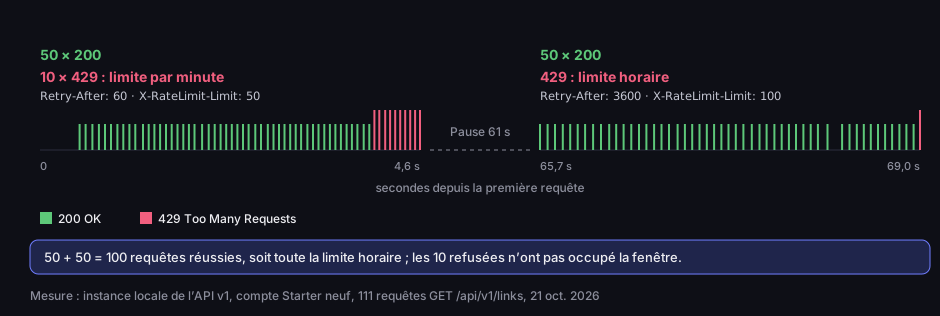
Les limites de débit en pratique : offre Starter, 50 par minute et 100 par heure
111 requêtes GET /api/v1/links sur un compte neuf, instance locale
Mesuré : instance locale de l’API v1, compte Starter neuf, 21 oct. 2026
Description de la figure
Chronologie. Les 50 premières requêtes en environ 4 secondes : 200 OK. Les 10 suivantes : 429, limite par minute, en-têtes Retry-After: 60 et X-RateLimit-Limit: 50. Le client attend 61 secondes. Ensuite 50 requêtes 200 OK et un 429 à la limite horaire, Retry-After: 3600, X-RateLimit-Limit: 100. Au total 50 plus 50, soit 100 requêtes réussies, toute la limite horaire ; les 10 refusées n’ont pas occupé la fenêtre.
La mesure montre trois choses pratiques. D’abord, avec un 429, notre API envoie Retry-After ainsi que les en-têtes X-RateLimit-Limit, X-RateLimit-Remaining et X-RateLimit-Reset. Une réponse réussie normale ne les porte pas : ne comptez donc pas sur eux pour suivre votre consommation au fil de l’eau. Ensuite, notre Retry-After donne la durée complète de la fenêtre : 60 secondes pour la limite par minute et 3 600 pour la limite horaire. C’est généreux, car dans une fenêtre glissante une place peut se libérer plus tôt, mais un client qui s’y conforme tombera toujours dans une fenêtre ouverte.
Enfin, une requête refusée n’entame pas la limite. Après 50 requêtes réussies et 10 refusées, la pause a suffi pour que 50 autres passent, soit 100 au total, toute la limite horaire, et la requête suivante a reçu un 429 avec Retry-After: 3600. Réessayer avant l’échéance de Retry-After ne coûte donc rien sur la limite, mais n’accélère rien non plus : cela se termine en général par un nouveau 429 et ne fait qu’ajouter du trafic. La bonne réaction à un 429 est de lire Retry-After, d’attendre, et seulement ensuite de renvoyer la requête.
Pagination : numéros de page ou curseur
Une liste de ressources tient rarement dans une seule réponse, une API la découpe donc en pages. Il existe deux approches, et notre API utilise les deux, chacune là où elle convient.
La liste des liens utilise des numéros de page. Les paramètres page et limit (de 1 à 100, 20 par défaut) se placent dans la partie de l’URL après le point d’interrogation, par exemple GET /api/v1/links?page=2&limit=50, et en plus de data, la réponse contient un objet pagination avec page, limit, total_pages, total_items et has_more. Quand has_more vaut false, vous avez terminé. C’est simple et suffisant, car une liste de liens change rarement.
Le flux d’événements, clics et scans, grandit sans cesse, et les numéros de page le fausseraient. Un commentaire dans notre code explique pourquoi : avec une pagination par décalage, un nouvel événement arrivant entre deux pages « décale tout vers le bas », et l’appelant relit ou saute silencieusement une ligne. Les événements sont donc paginés avec un curseur : la réponse renvoie next_cursor, un horodatage encodé et l’ID du dernier événement, et la requête suivante demande tout ce qui vient après. Le résultat reste stable, quel que soit le nombre d’événements arrivés entre-temps.
La règle : des numéros de page pour les collections qui ne bougent pas ; un curseur pour les flux qu’un programme lit du début à la fin.
REST, SOAP et GraphQL
REST n’est pas la seule façon de construire une API, mais c’est la plus courante. L’enquête Postman 2025 montre ce qu’utilisent les équipes, plusieurs réponses étant possibles :
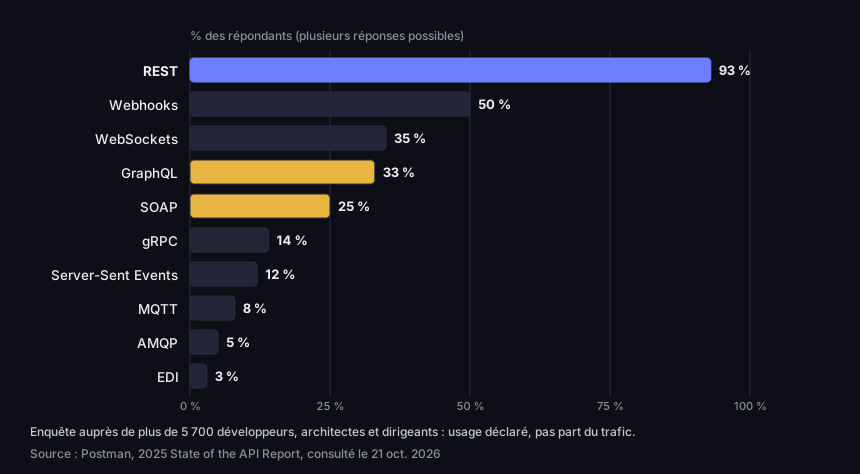
Les styles d’API utilisés par les équipes (Postman 2025)
part des répondants, plusieurs réponses possibles
Source : Postman, 2025 State of the API Report, consulté le 21 oct. 2026
Description de la figure
Diagramme à barres. REST 93 %, Webhooks 50 %, WebSockets 35 %, GraphQL 33 %, SOAP 25 %, gRPC 14 %, Server-Sent Events 12 %, MQTT 8 %, AMQP 5 %, EDI 3 %. Une enquête auprès de plus de 5 700 développeurs, architectes et dirigeants ; usage déclaré, pas part du trafic.
Les trois styles les plus souvent comparés diffèrent sur le fond :
|
Caractéristique |
REST |
SOAP |
GraphQL |
|---|---|---|---|
|
Ce que c’est |
un style d’architecture (Fielding, 2000) |
un protocole de messagerie (W3C) |
un langage de requête (spécification GraphQL) |
|
Message |
une représentation d’une ressource, le plus souvent JSON |
une enveloppe XML ( |
réponse le plus souvent en JSON |
|
Qui façonne la réponse |
le serveur |
le serveur, selon le contrat |
le client décrit les données dont il a besoin |
|
Description de l’interface |
OpenAPI |
WSDL (un langage XML pour les services) |
schéma GraphQL |
Selon le W3C, SOAP est « un protocole léger destiné à l’échange d’informations structurées dans un environnement décentralisé et distribué » (W3C, SOAP 1.2, en anglais). Il s’appuie sur les technologies XML : chaque message est une enveloppe (Envelope) avec un en-tête facultatif et un corps, et un service est décrit en WSDL, un langage XML de description de services web (W3C, WSDL 2.0, en anglais). Il est toujours utilisé : 25 % des répondants de l’enquête Postman s’en servent.
GraphQL est « un langage de requête conçu pour construire des applications clientes », dans lequel le client décrit les données dont il a besoin (spécification GraphQL, septembre 2025, en anglais). Avec REST, le serveur fixe la forme de la réponse et vous obtenez la ressource entière ; avec GraphQL, vous listez exactement les champs voulus, y compris issus de plusieurs objets liés à la fois. 33 % des répondants l’utilisent.
Certains guides prétendent que REST est « X % plus rapide » que SOAP : nous n’avons trouvé aucune mesure à l’appui. Le choix pratique est plus simple : REST pour une API publique utilisée par de nombreuses équipes et de nombreux outils ; SOAP quand le système auquel vous vous connectez l’exige ; GraphQL quand un client doit combiner de nombreuses ressources de façon souple.
Pour les API HTTP, le format de description standard est OpenAPI : une spécification qui permet aux personnes comme aux programmes de découvrir les capacités d’un service « sans avoir besoin d’accéder au code source, à de la documentation supplémentaire ni d’inspecter le trafic réseau » (OpenAPI Specification 3.1.0, en anglais). Notre API a un tel fichier, en version 3.1.0, et la documentation interactive plus bas en est issue.
Votre premier appel : l’API REST d’un raccourcisseur d’URL
Notre API permet de créer, lire, modifier et supprimer des liens courts, et d’obtenir leurs codes QR et leurs statistiques. Elle est disponible à partir de l’offre Starter, ainsi que pendant la période d’essai de 7 jours d’un nouveau compte ; il n’est pas possible de créer une clé avec l’offre Gratuit. Le détail des offres figure sur la page des tarifs.
Il y a trois étapes. D’abord, créez un compte puis, dans Paramètres → Clés API, cliquez sur « Créer une clé ». Le serveur n’affiche la clé qu’une seule fois. Envoyez ensuite une requête avec la clé dans l’en-tête Authorization :
1curl -i -X POST https://dvnlinks.pl/api/v1/links \2 -H "Authorization: Bearer $DVN_API_KEY" \3 -H "Content-Type: application/json" \4 -d '{"original_url": "https://example.com/offer"}'L’option -i affiche le code d’état et les en-têtes de la réponse. Attendez-vous à un 201 et à un objet data avec un champ short_url. Enfin, lisez le lien que vous venez de créer, grâce à son id :
1curl https://dvnlinks.pl/api/v1/links/LINK_ID \2 -H "Authorization: Bearer $DVN_API_KEY"Conservez la clé dans une variable plutôt que dans la commande elle-même, afin qu’elle n’apparaisse pas dans l’historique de votre shell. L’ancienne méthode, qui passe la clé dans l’URL (?api_key=), fonctionne encore mais est en cours d’abandon : ces réponses portent les en-têtes Deprecation et Warning, car une URL contenant une clé finit dans les journaux. Pourquoi c’est dangereux et comment conserver une clé, c’est l’objet du guide sur les clés API ; la marche à suivre pas à pas se trouve dans la documentation des clés API.
Chaque point d’accès est décrit dans la spécification OpenAPI 3.1.0 et dans la documentation interactive à l’adresse /api/reference, où vous pouvez envoyer des requêtes directement depuis votre navigateur. Les mêmes étapes dans le tableau de bord, de l’inscription au premier lien, sont dans Premiers pas ; la documentation propose aussi une introduction à l’API. Ce que l’API ne fait pas : elle ne crée pas de pages bio ni de codes QR menant à des fichiers, et n’a aucune opération en masse, chaque lien étant une requête distincte. Les notifications de clics vers votre serveur existent sous forme de webhooks à partir de l’offre Pro ; elles se configurent dans les paramètres du tableau de bord, pas par l’API. La liste complète des fonctionnalités se trouve sur la page des fonctionnalités.
Questions fréquentes
Un contrat par lequel un programme en utilise un autre : quelles questions il peut poser et ce qui revient. Sur le web, le plus souvent via HTTP.
Une API construite selon les principes REST : les ressources ont leurs propres URL, les opérations sont des méthodes HTTP et le serveur ne garde aucun état de session. En pratique, « RESTful » et « API REST » désignent la même chose, une API HTTP de style REST, même si, selon la définition de Fielding, aucune des deux n’est entièrement REST sans hypermédia.
SOAP est un protocole du W3C avec une enveloppe XML et un contrat en WSDL ; REST est un style fondé sur HTTP, le plus souvent avec JSON. Choisissez SOAP quand le système auquel vous vous connectez l’exige.
Non. Fielding parle de représentations d’une ressource, dont le format est un type de média : « Le format de données d’une représentation est appelé un type de média » (chap. 5, en anglais). JSON est une convention, pas une obligation : la même API pourrait renvoyer du XML ou du CSV.
Que vous avez envoyé trop de requêtes dans un laps de temps donné. Lisez l’en-tête Retry-After et attendez ce nombre de secondes ; réessayer aussitôt aboutit en général à un nouveau 429.
Envie de voir une API REST à l’œuvre sur votre propre compte ? Créez un compte, générez une clé et créez un lien avec une seule commande curl : l’API est disponible à partir de l’offre Starter et pendant la période d’essai.